1. Mở đầu
Trong một ứng dụng tiếp nhận tài liệu khách hàng, hóa đơn, biên lai và hợp đồng có thể đi vào cùng một luồng upload. Phần xử lý sau đó lại khác nhau. Hóa đơn cần trích xuất số tiền phải trả, biên lai cần xác nhận giao dịch, còn hợp đồng thường cần tóm tắt điều khoản. Trước khi làm các việc đó, ứng dụng cần biết tài liệu thuộc loại nào.
Một cách triển khai là gửi nội dung cho Gemini rồi yêu cầu model trả về đúng một nhãn. Gemini Decisions API cung cấp một cách khác để thực hiện bước này. Demo dưới đây gọi cả hai API trên cùng 48 tài liệu văn bản giả lập và so sánh độ chính xác, độ trễ và chi phí token. Dữ liệu được tự soạn theo các tình huống thường gặp khi phân luồng tài liệu.
2. Tổng quan về Gemini Decisions API
Gemini Decisions API dùng model gemini-decision-1 để đánh giá các phương án đã định nghĩa. API hỗ trợ câu hỏi có/không (noul), lựa chọn trong một tập đáp án (choice) và chấm theo thang điểm có thứ tự (score). Nhiều câu hỏi độc lập có thể dùng chung một đầu vào. Tài liệu Decisions API
Với choice, ứng dụng gửi tài liệu kèm tên nhãn và tiêu chí của từng nhãn. API trả về lựa chọn, xác suất từng phương án và confidence. Nhánh so sánh dùng Gemini 3.5 Flash-Lite. Model đọc cùng nội dung và tiêu chí dưới dạng prompt rồi sinh một nhãn văn bản. Code kiểm tra nhãn trước khi xử lý tiếp.
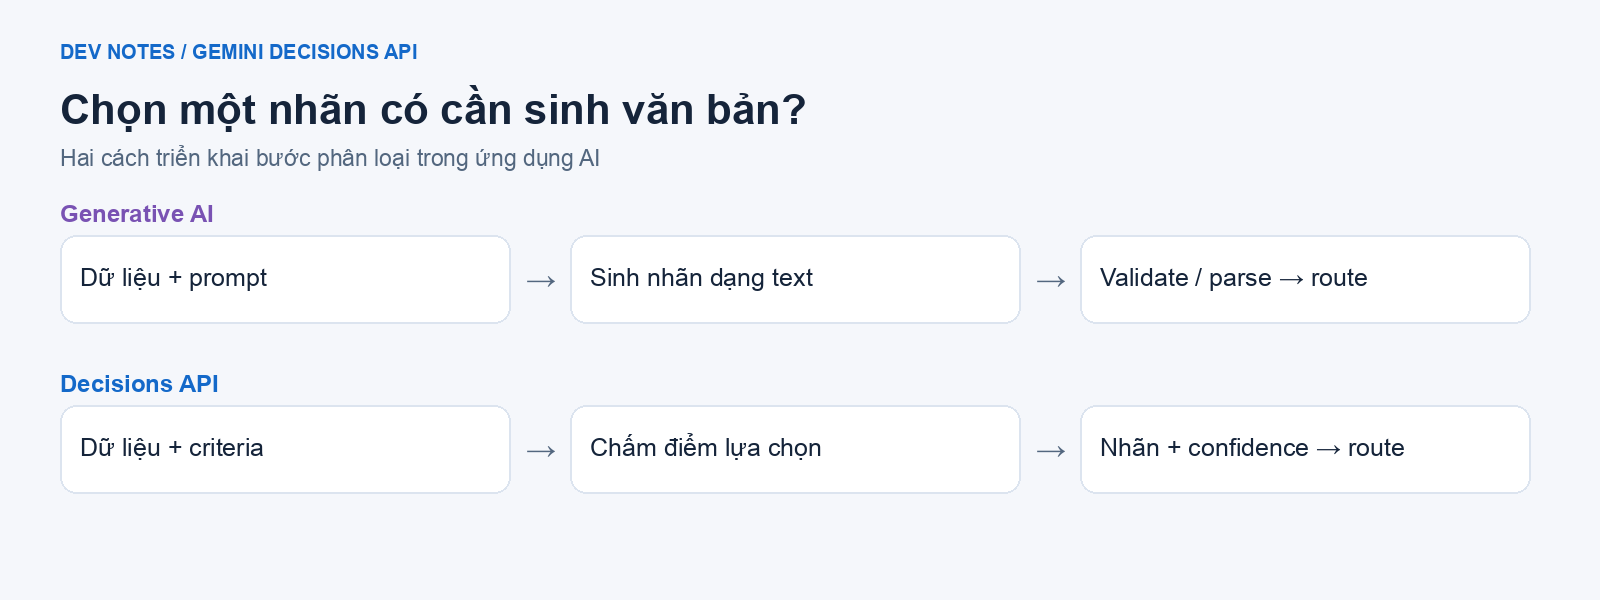
Ứng dụng có thể dùng confidence để chuyển trường hợp khó sang hàng đợi kiểm tra. Ngưỡng phù hợp phụ thuộc vào chất lượng dự đoán trên dữ liệu của luồng đó và hậu quả khi chuyển nhầm tài liệu.
3. Thiết kế bộ dữ liệu và phép đo
Bộ dữ liệu
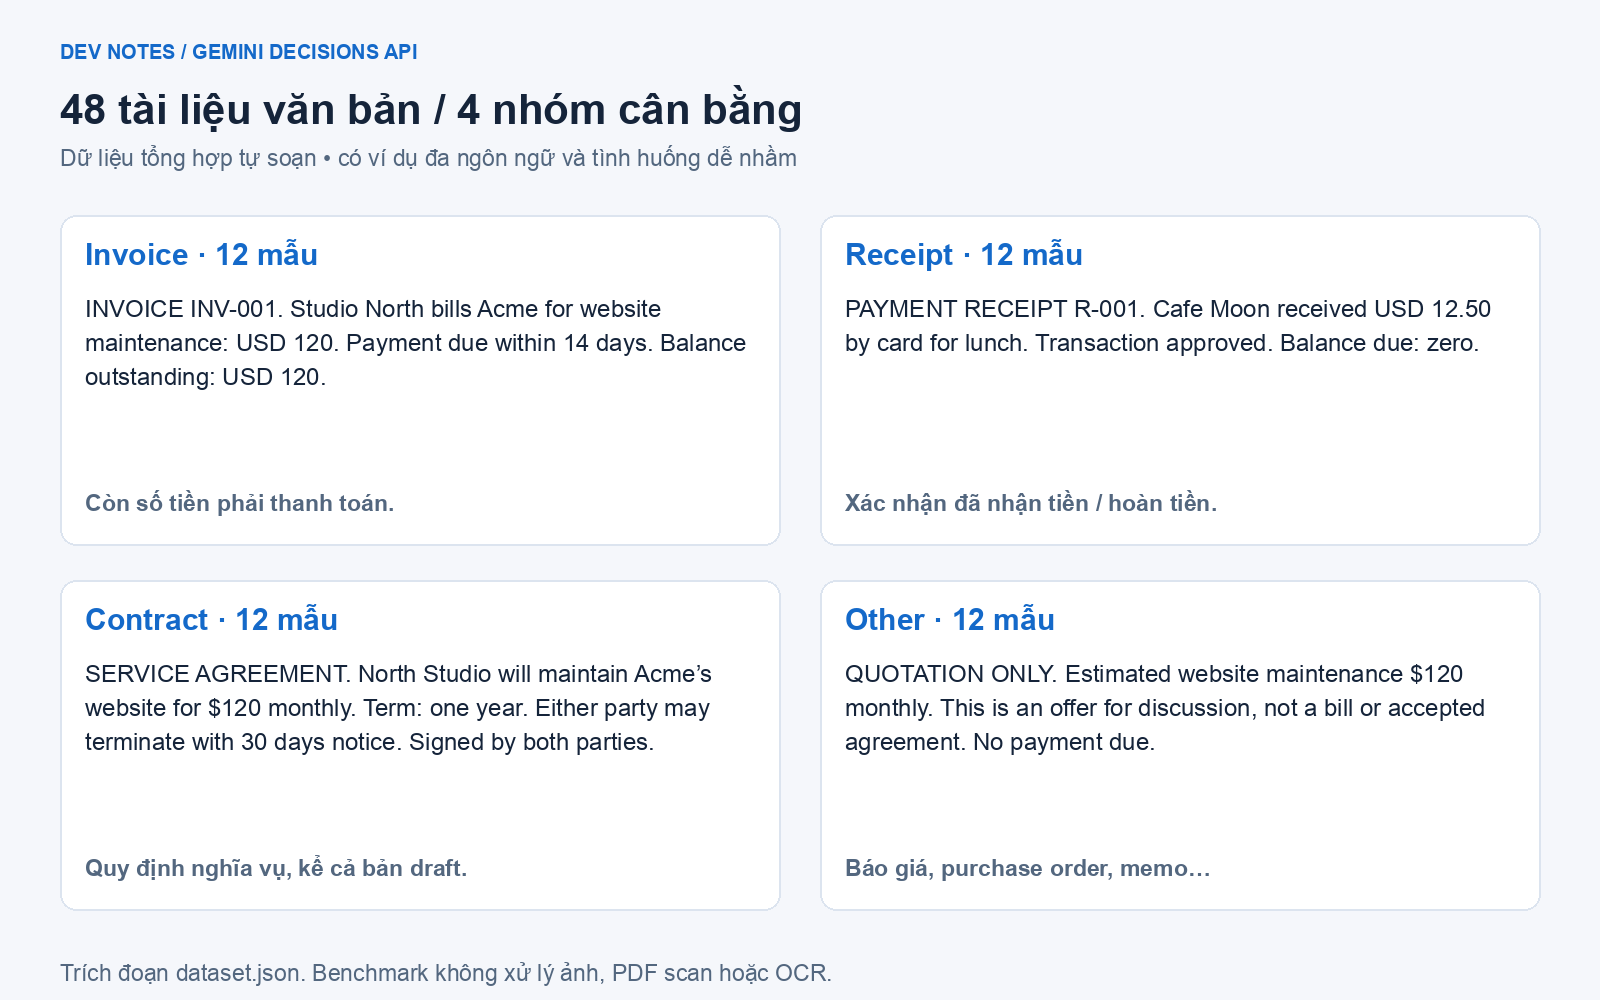
Bộ dữ liệu gồm bốn nhóm, mỗi nhóm 12 tài liệu. Nhãn tham chiếu được gán trước dựa trên mục đích của tài liệu. Một hóa đơn còn số dư thuộc Invoice, trong khi bản xác nhận đã thanh toán đủ thuộc Receipt. Nhóm Contract có cả bản nháp quy định nghĩa vụ giữa các bên. Báo giá và ghi chú nội bộ là ví dụ thuộc Other. Tải bộ dữ liệu và nhãn tham chiếu
Cách tính các chỉ số
- Độ chính xác được tính trên tổng lượt gọi và trên riêng các phản hồi hợp lệ. Thiếu phản hồi hoặc sai định dạng làm giảm tỷ lệ đúng trên tổng lượt gọi.
- Độ trễ được đo phía client, gồm thời gian kết nối HTTP/TLS, chờ dịch vụ và đọc JSON. Báo cáo liệt kê trung bình và P95 trên phản hồi hợp lệ, kèm trung bình của toàn bộ lượt gọi.
- Chi phí được ước tính từ input và output tokens do API báo về, áp đơn giá standard paid tier rồi quy đổi về 1.000 tài liệu.
Runner xáo thứ tự tài liệu và thứ tự hai model trong từng cặp bằng seed cố định. Các request chạy tuần tự, cách nhau một giây, dùng kết nối mới, không warmup hay retry. Mỗi model nhận cùng nội dung và tiêu chí phân loại. Xem cấu hình lần chạy
4. Thực hành với runner Python
Bước 1. Chuẩn bị môi trường
Runner dùng Python 3.10 trở lên và thư viện chuẩn. Đặt benchmark.py và dataset.json trong cùng thư mục, sau đó cấu hình GEMINI_API_KEY trong môi trường hoặc file .env. Có thể bắt đầu bằng bộ kiểm thử cục bộ và một tài liệu để xác nhận hai API phản hồi đúng định dạng.
Bộ kiểm thử kiểm tra cách tạo request, đọc response và tính chỉ số. Lần gọi thử trên một mẫu kiểm tra thêm kết nối thật tới hai API. Mã runner · Kết quả gọi thử
Bước 2. Kiểm tra request và response của hai phương pháp
Để xem đúng payload mà runner gửi, có thể gọi hàm payload() trên cùng một mẫu. Đoạn Python sau in hai JSON mà không gửi request.
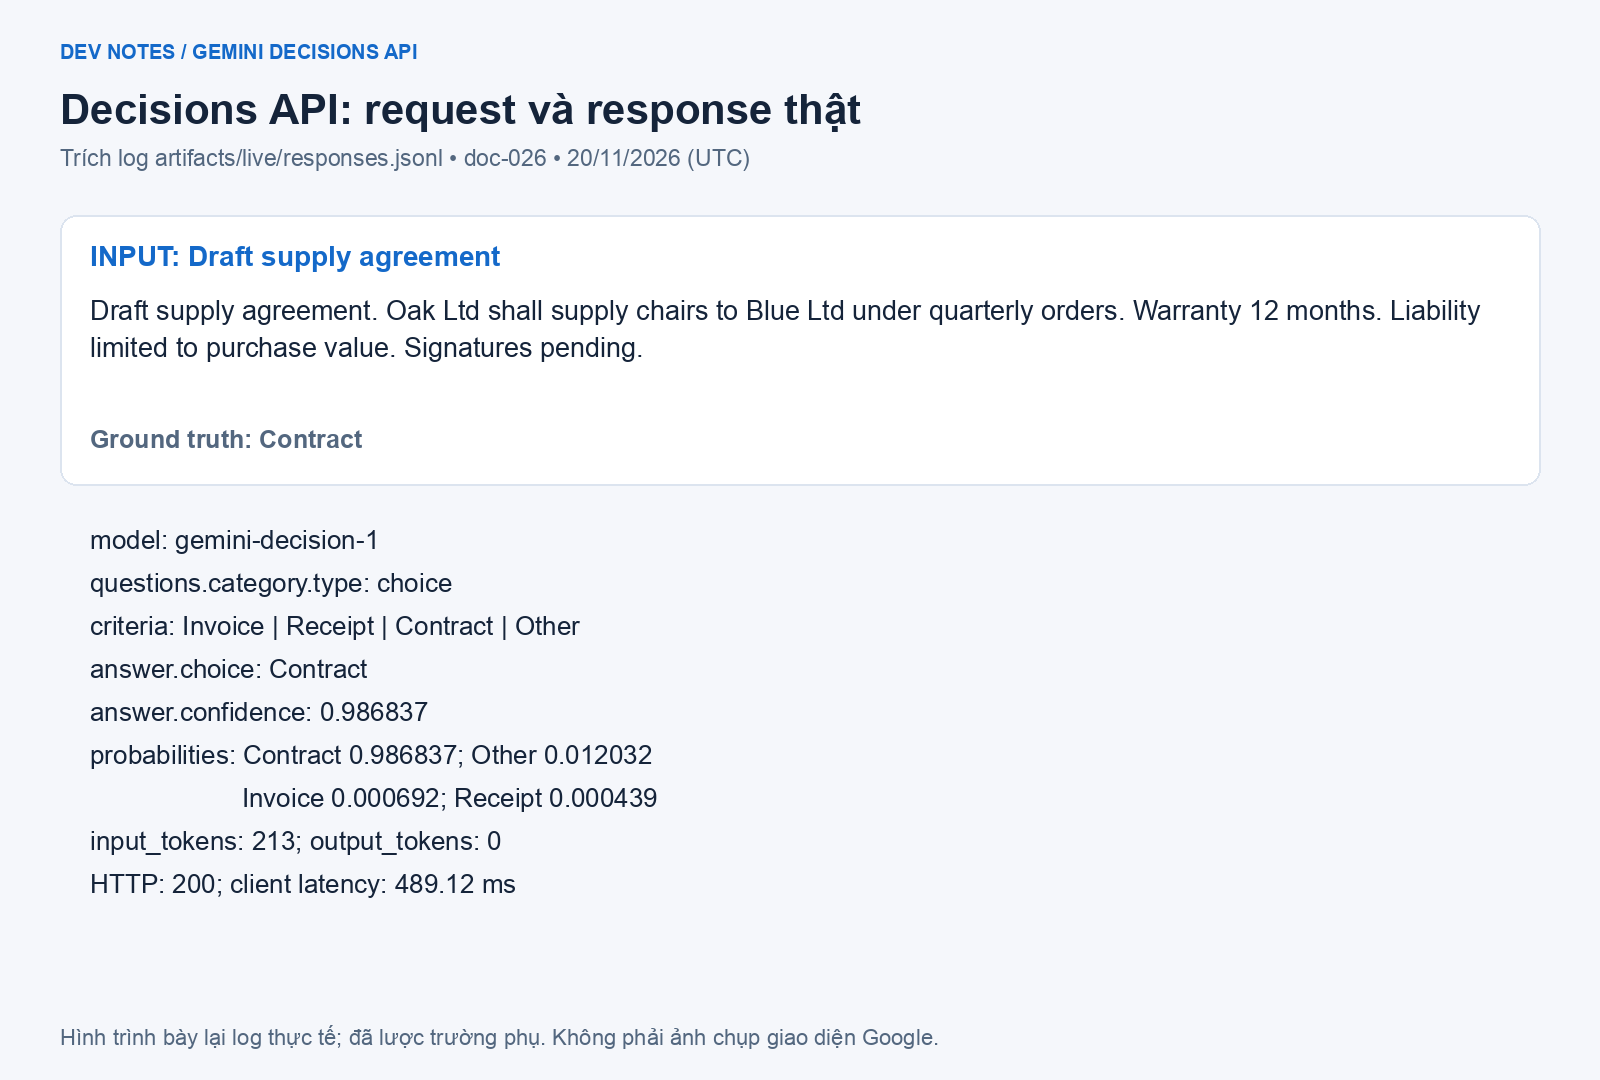
Nhánh Decisions gửi POST /v1beta/decisions. Phần questions.category chứa loại choice, hướng dẫn và tiêu chí của bốn nhãn. Với bản nháp hợp đồng doc-026, response trả về Contract với confidence khoảng 0,987.
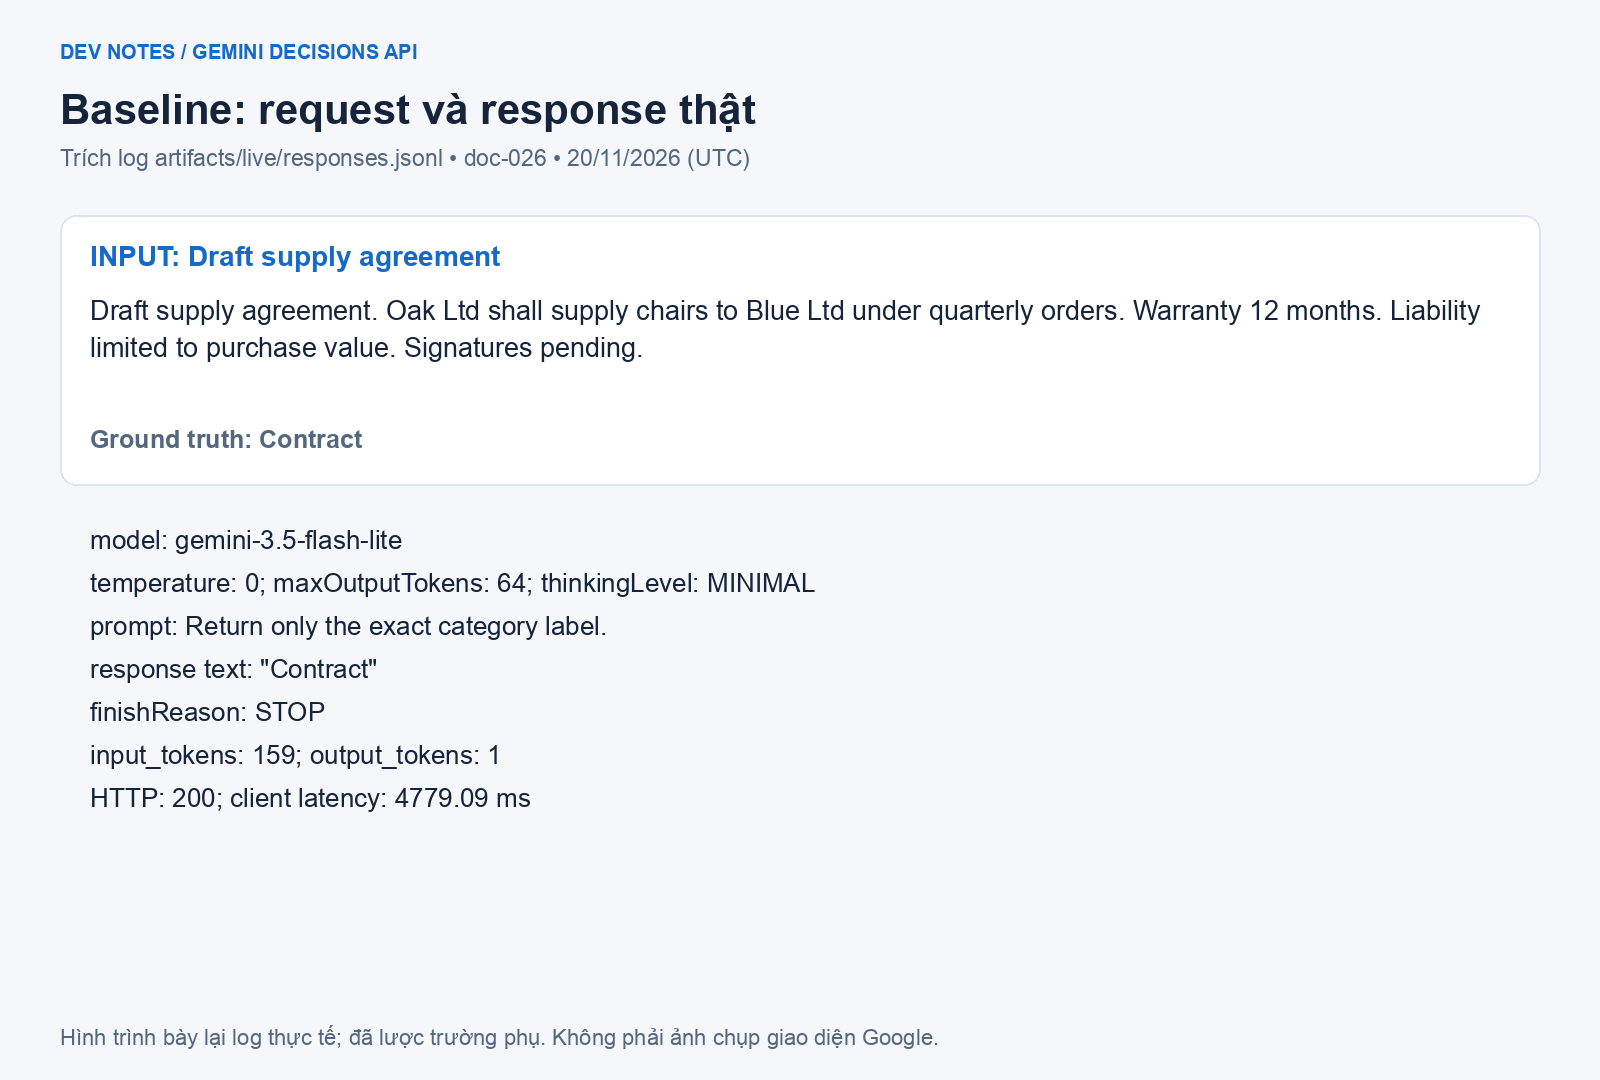
Nhánh Flash-Lite dùng generateContent, với temperature = 0, thinking ở mức MINIMAL và giới hạn 64 output tokens. Prompt yêu cầu trả đúng một nhãn. Response cho cùng mẫu là Contract, dùng 159 input tokens và một output token.
Bước 3. Chạy đủ 48 tài liệu và đối chiếu log
Runner gửi hai lượt gọi cho mỗi tài liệu. responses.jsonl lưu request, response, nhãn, token usage, độ trễ và lỗi nếu có. summary.csv tổng hợp chỉ số theo model. Có thể dùng lệnh python3 benchmark.py report artifacts/new-run để tạo lại báo cáo từ log đã lưu. Log của lần chạy dùng trong bài
5. Kết quả thử nghiệm
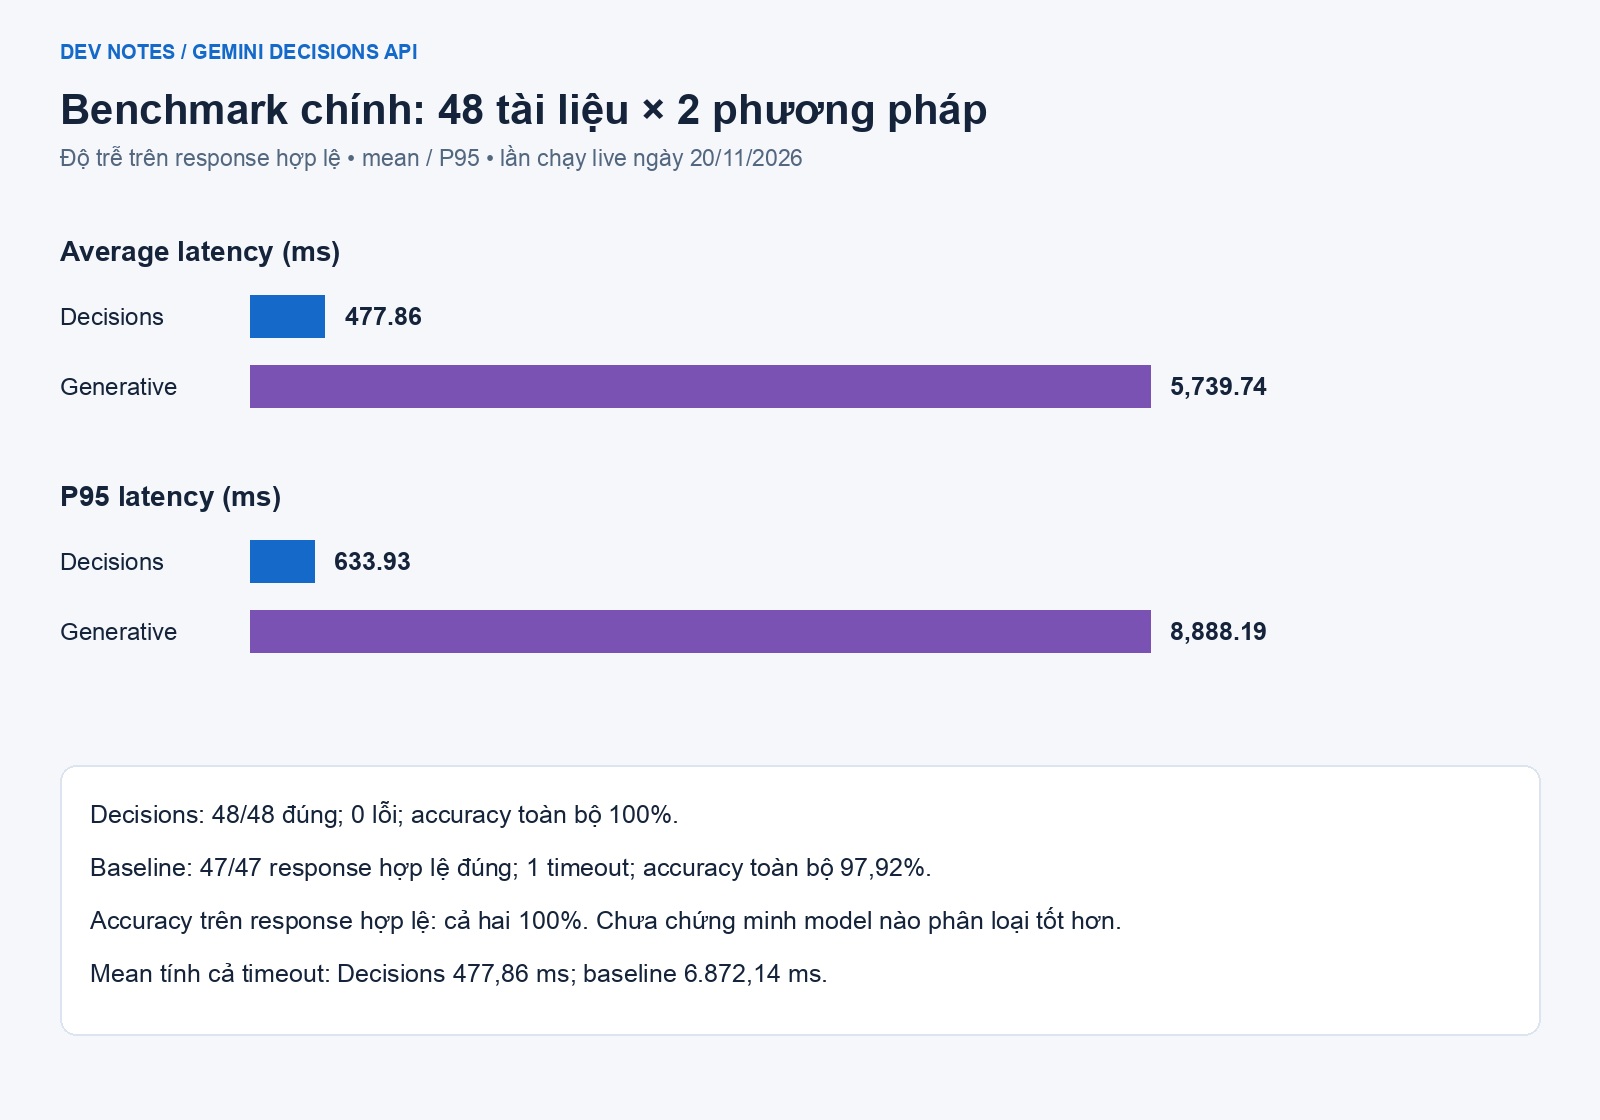
Ngày 20/11/2026, lần chạy chính gửi đủ 96 lượt gọi. Decisions trả đúng nhãn cho 48 tài liệu. Flash-Lite trả đúng nhãn ở cả 47 phản hồi nhận được và gặp một lần timeout khi đọc kết quả của doc-004. Tải CSV kết quả
| Chỉ số | Decisions API | Flash-Lite |
|---|---|---|
| Đúng trên tổng lượt gọi | 48/48 (100%) | 47/48 (97,92%) |
| Đúng trên phản hồi hợp lệ | 48/48 (100%) | 47/47 (100%) |
| Lỗi | 0/48 (0%) | 1/48 (2,08%) |
| Độ trễ trung bình, phản hồi hợp lệ | 477,86 ms | 5.739,74 ms |
| P95, phản hồi hợp lệ | 633,93 ms | 8.888,19 ms |
| Độ trễ trung bình, mọi lượt gọi | 477,86 ms | 6.872,14 ms |
Chi phí token trên cùng 47 tài liệu
Đơn giá standard paid tier ngày đo, tính trên một triệu token, là 0,10 USD input và 0 USD output cho Decisions, 0,30 USD input và 2,50 USD output cho Flash-Lite. Giá output của Flash-Lite bao gồm thinking tokens nếu phát sinh. Thông báo Gemini Decisions API · Bảng giá Flash-Lite
Trên cùng 47 tài liệu có usage ở cả hai phía, Decisions dùng 10.008 input tokens và 0 output tokens. Flash-Lite dùng 7.470 input tokens và 47 output tokens. Theo lượng token trung bình đo được, 1.000 tài liệu tương tự ước tính tốn 0,02129 USD với Decisions và 0,05018 USD với Flash-Lite, chênh khoảng 57,6%. Bảng tính chi phí theo cặp
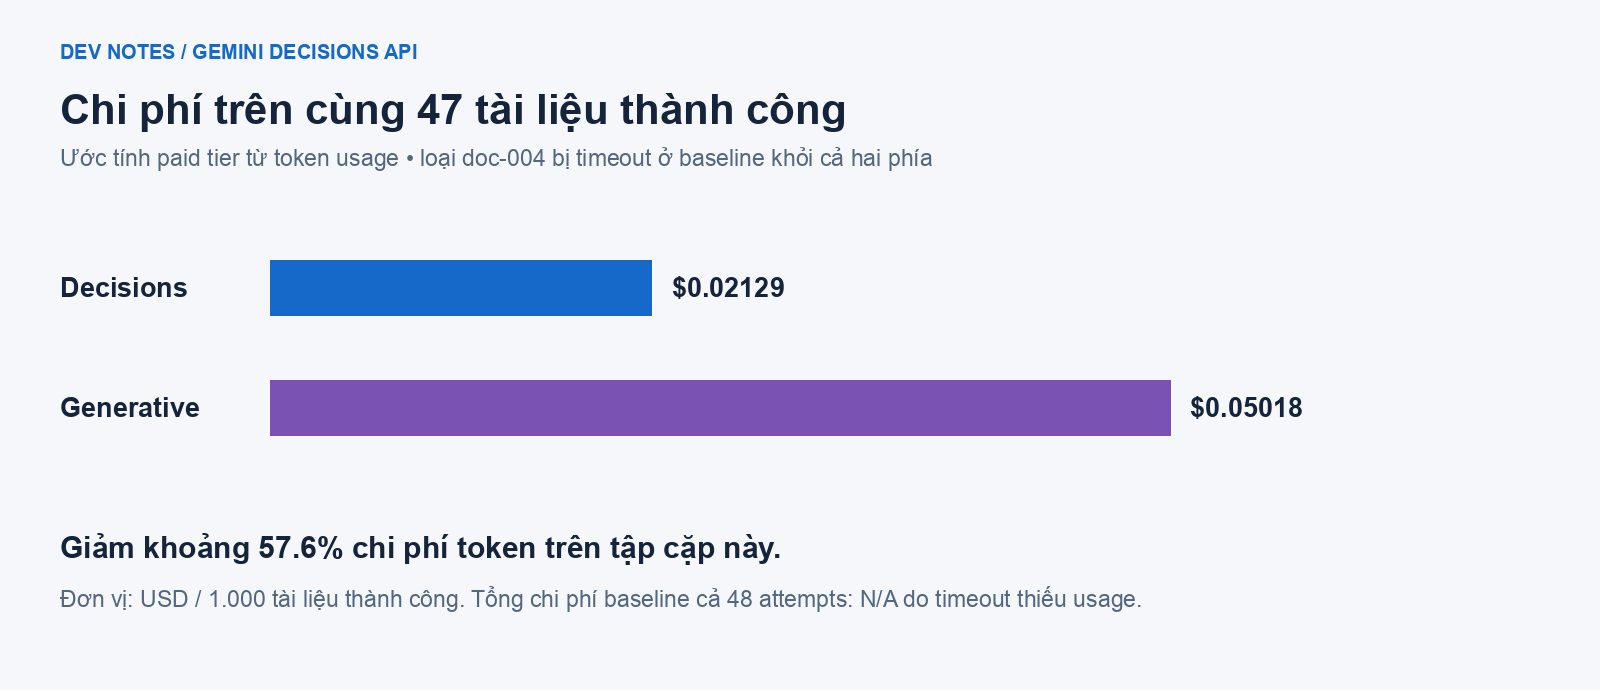
Trên toàn bộ 48 lượt gọi, chi phí Decisions quy đổi là 0,02131 USD trên 1.000 lượt. Flash-Lite thiếu token usage của lượt timeout nên chưa có con số toàn bộ tương ứng.
6. Giới hạn của demo
Chênh lệch độ chính xác trên tổng lượt gọi đến từ timeout. Với các phản hồi hợp lệ, cả hai model đều đạt 100% trên bộ tài liệu ngắn tự soạn. Cần thêm mẫu khó và dữ liệu thực tế để đánh giá khác biệt về chất lượng phân loại và chọn ngưỡng confidence. Demo gửi văn bản trực tiếp, nên ảnh, PDF scan và OCR cần được đo riêng.
Ở lần thử bổ sung, độ trễ trung bình của các phản hồi hợp lệ là 453,73 ms với Decisions và 1.746,79 ms với Flash-Lite. Lần này dừng khi Flash-Lite gặp HTTP 429, sau 81/144 lượt gọi dự kiến ở mỗi model. Decisions có độ trễ thấp hơn ở cả hai lần đo, với mức chênh lệch thay đổi theo lần chạy. Kết quả phần đã chạy
7. Ứng dụng vào công việc hằng ngày
Theo tôi, trường hợp phù hợp nhất là phân luồng đầu vào có sẵn các lựa chọn và mỗi lựa chọn dẫn đến một cách xử lý cụ thể. Trong các dự án tiếp nhận tài liệu khách hàng, tôi sẽ thử dùng Decisions ngay sau bước upload. Hóa đơn và biên lai đi vào pipeline trích xuất ngày, số tiền và mã tham chiếu. Hợp đồng chuyển sang bước tóm tắt bằng generative AI. Tài liệu thuộc nhóm Other, có confidence thấp hoặc gặp lỗi API sẽ vào hàng đợi kiểm tra.
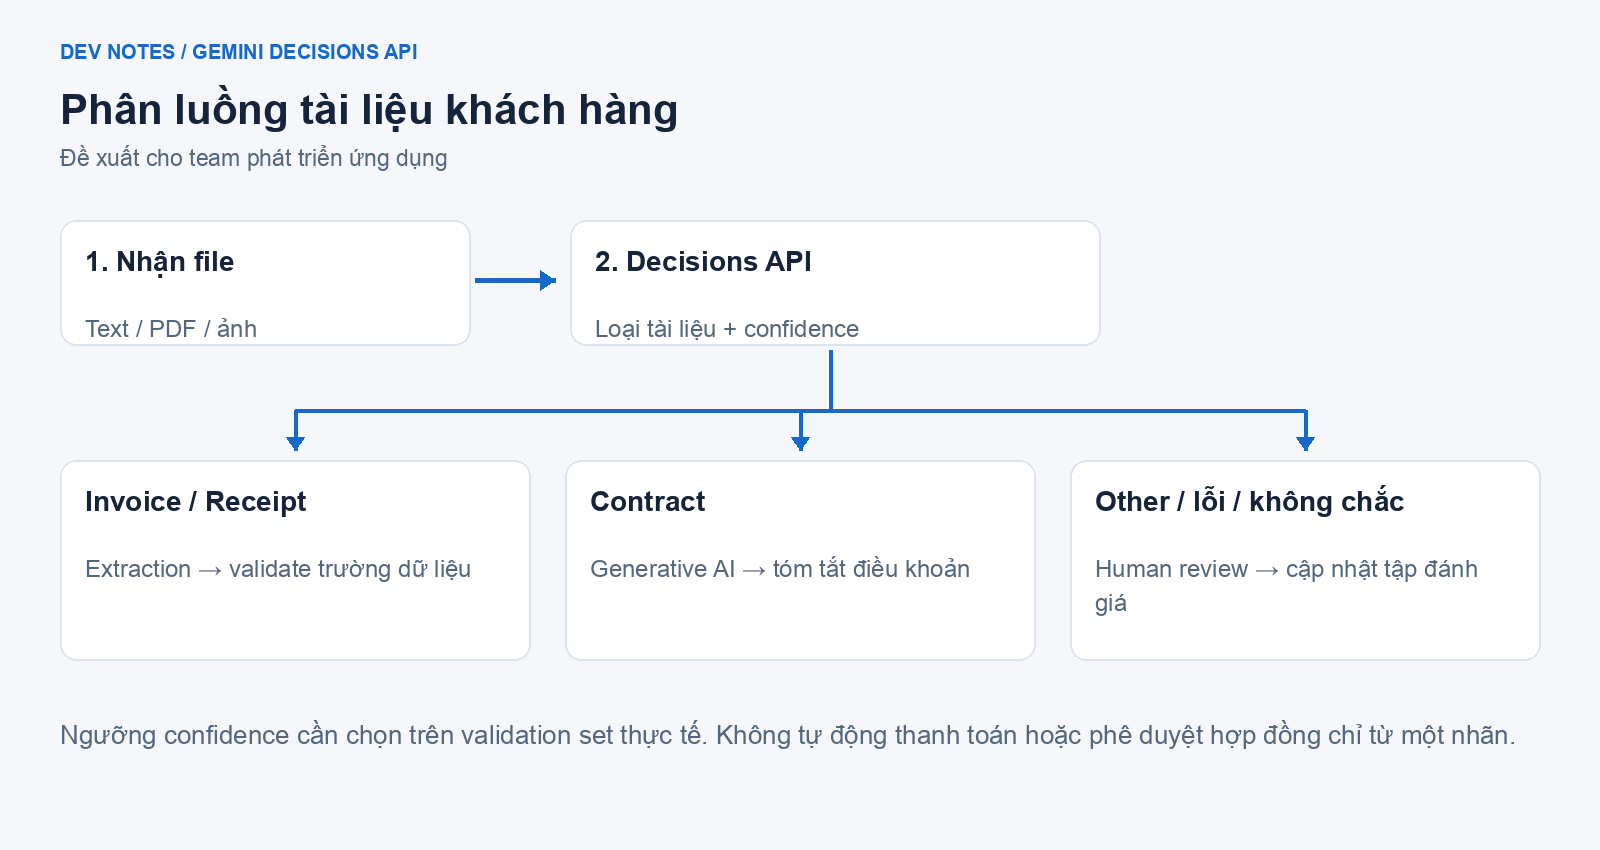
Có thể bắt đầu bằng cách chạy phân loại song song với quy trình hiện tại và so nhãn với kết quả team đã xác nhận. Sau đó, team chọn ngưỡng confidence và đánh giá trên một tập tài liệu riêng. Tỷ lệ chuyển đúng, số hồ sơ cần review và thời gian xử lý từ lúc nhận file đến lúc có kết quả sẽ cho thấy bước mới có giảm được công việc hằng ngày hay không.
Luồng thử nghiệm cũng cần tính thời gian và chi phí khi phải gọi model dự phòng, nhất là sau timeout hoặc khi chạm giới hạn quota. Nếu mọi file vẫn đi qua cùng một pipeline, bước phân loại sẽ cộng thêm một lượt gọi API. Trong trường hợp đó, lợi ích cần đến từ việc thay đổi prompt, cấu hình trích xuất hoặc ưu tiên kiểm tra cho từng loại tài liệu.