Tôi thường lặp lại hai việc với coding agent: biến một yêu cầu còn mơ hồ thành thứ có thể triển khai, rồi review code trước khi merge. Vì thế tôi muốn kiểm tra một điều đơn giản: có thể viết quy trình đó một lần, đặt vào Agent Skill, rồi dùng lại trên Claude Code và Codex không?
Tôi đã thử với một Skill thật, một tình huống Todo List nhỏ và hai tác vụ: làm rõ yêu cầu và review code. Kết quả ngắn gọn là: có, trong phạm vi thử nghiệm này. Cùng một Skill chạy được trên hai CLI; cả Claude Code và Codex đều đạt 8/8 theo cùng bảng tiêu chí. Điều đó không có nghĩa hai model giống nhau; nó chỉ cho thấy quy trình có thể mang từ công cụ này sang công cụ khác.
Toàn bộ source, kết quả chạy, ảnh và video nằm trong repository public.
Agent Skill là gì?
Hiểu đơn giản, Agent Skill là một thư mục dạy agent làm một công việc lặp lại. File chính là ‘SKILL.md’: nó nói Skill dùng khi nào, cần xem gì và phải trả kết quả theo cấu trúc nào. Thư mục có thể kèm tài liệu, script hoặc mẫu biểu nếu cần.
Đây không chỉ là quy ước tự đặt. Đặc tả Agent Skills quy định ‘SKILL.md’ có YAML frontmatter và nội dung Markdown; ‘name’ cùng ‘description’ là hai trường bắt buộc. Claude Code Skills, Codex Skills và GitHub Copilot Agent Skills đều hỗ trợ cách đóng gói workflow lặp lại này.
Skill tôi đã tạo
Skill trong thử nghiệm là requirements-and-review. Nó chỉ dùng hai trường chuẩn ‘name’ và ‘description’, không có cấu hình riêng cho Claude Code hay Codex.
Skill có hai cách làm việc:
- Làm rõ yêu cầu: tách outcome, phạm vi, câu hỏi còn mở, giả định, tiêu chí chấp nhận, rủi ro và quyết định kế tiếp.
- Review code: chỉ nêu lỗi có bằng chứng; mỗi lỗi cần có mức độ ưu tiên, vị trí ‘file:line’, tình huống gây lỗi và phần đã kiểm tra.
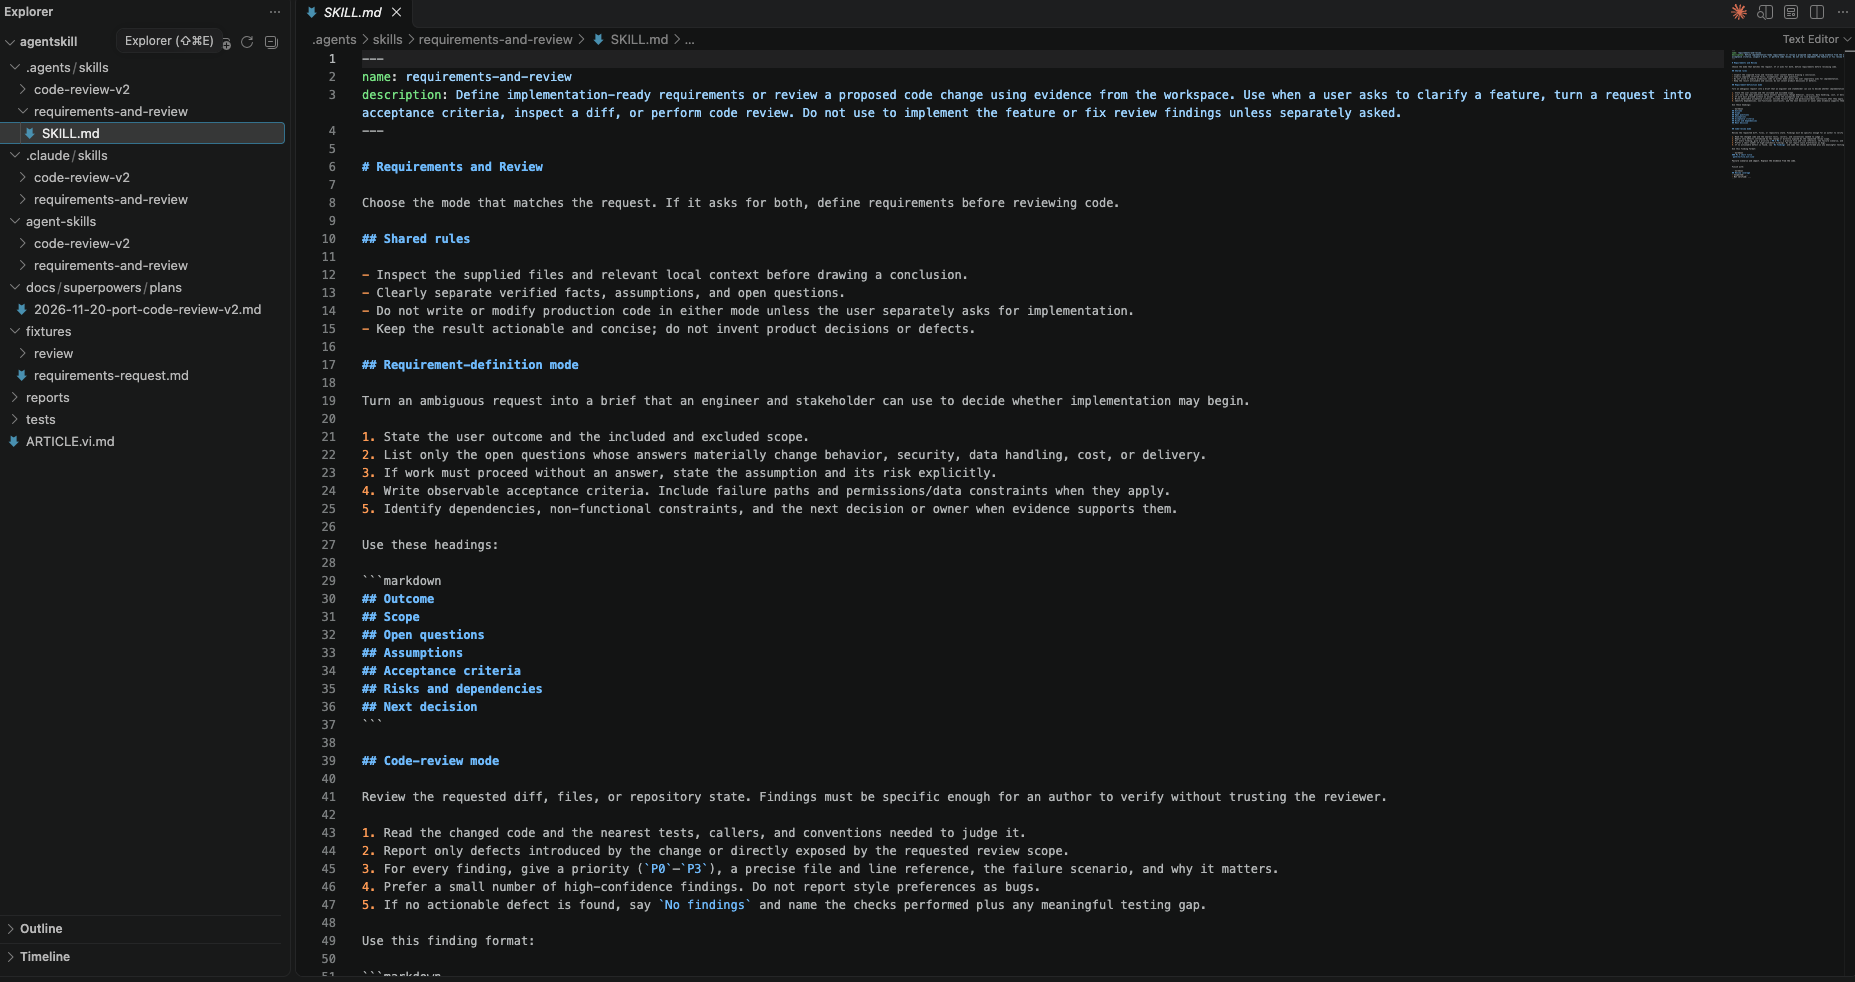
Cùng nội dung được cài tại ‘.claude/skills/requirements-and-review/’ cho Claude Code và ‘.agents/skills/requirements-and-review/’ cho Codex.
Bạn có thể đối chiếu bản gốc, bản cài cho Claude Code và bản cài cho Codex.
Ví dụ xuyên suốt: Shared Todo List
Tôi chọn một yêu cầu quen thuộc: thành viên trong workspace tạo task, giao task cho người khác và đánh dấu hoàn thành. Web Todo List dưới đây chỉ tạo bối cảnh sản phẩm để người đọc dễ hình dung; Skill không tạo web này và giao diện không được dùng để chấm kết quả.
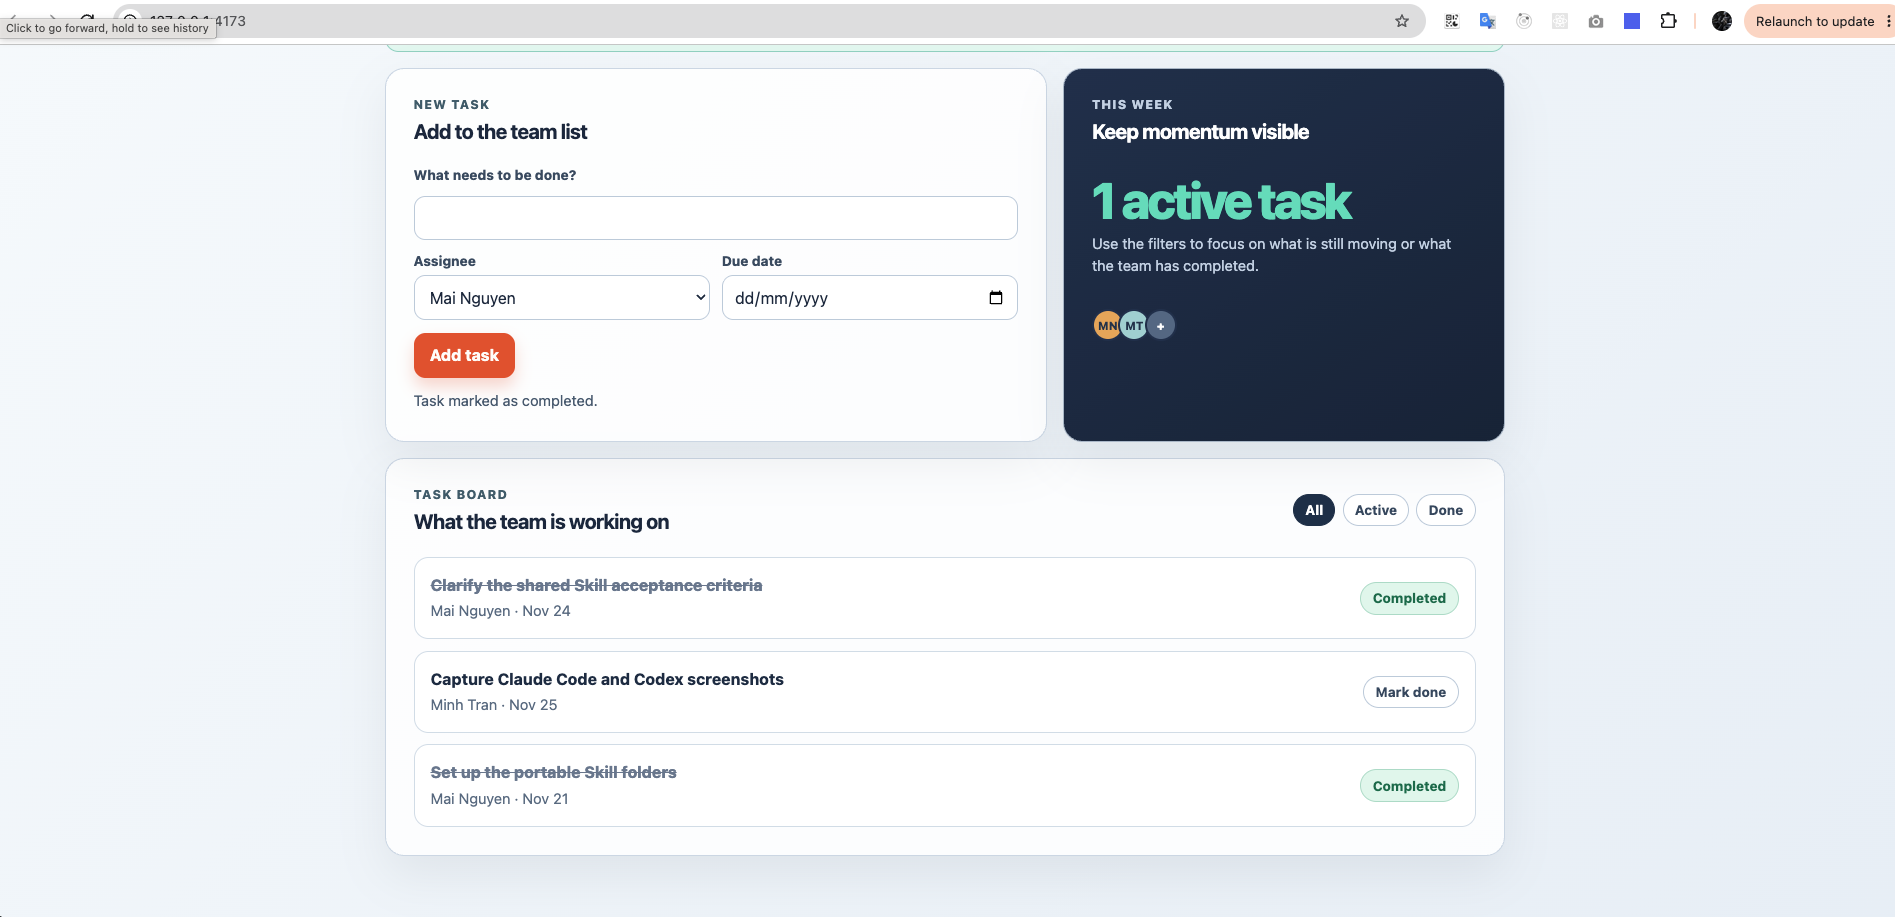
Yêu cầu ban đầu lại chưa trả lời những câu quan trọng:
- Ai được sửa hoặc xoá task của người khác?
- Deadline có timezone không? Có task lặp lại không?
- Task hoàn thành được mở lại hay giữ bao lâu?
- Khi hai người sửa cùng lúc, hệ thống xử lý thế nào?
Đây là lúc mode “làm rõ yêu cầu” có ích. Thay vì tự đoán, agent phải biến những lỗ hổng này thành câu hỏi, giả định hoặc tiêu chí chấp nhận. Yêu cầu gốc cố ý để các quyết định đó trống.
Ở tác vụ review, tôi dùng một đoạn code nhỏ khác. Web Todo List chỉ là bối cảnh cho phần làm rõ yêu cầu; review dùng fixture lỗi độc lập để việc chấm điểm không bị lẫn với giao diện. Đoạn code này đổi tên task trước khi kiểm tra người gọi có thuộc workspace hay không. Request bị từ chối vẫn có thể để lại object trong bộ nhớ đã bị thay đổi. Đây là lỗi mà cả hai agent cần tìm ra.
Cách tôi kiểm tra
Tôi cài cùng một Skill cho hai CLI, đưa cho chúng cùng prompt, cùng tình huống kiểm thử và cùng bảng tiêu chí chấm. Bảng này không chấm câu chữ; nó chỉ kiểm tra những điều nhìn thấy được trong output.
| Tác vụ | Output phải có |
|---|---|
| Làm rõ yêu cầu | Outcome, scope, câu hỏi còn mở, giả định và tiêu chí chấp nhận |
| Review code | Lỗi mutation trước authorization, priority, ‘file:line’ và phạm vi review |
Hai prompt nguyên văn nằm trong runner. Rubric và toàn bộ transcript đều có trong báo cáo kiểm thử.
Về quyền ghi file, cần nói rõ: Codex chạy với ‘–sandbox read-only’. Claude Code nhận prompt yêu cầu chỉ tạo brief hoặc chỉ review; bản ghi này không chứng minh Claude có sandbox chỉ đọc tương đương. Đây là kiểm tra về khả năng tái sử dụng quy trình, không phải benchmark an toàn hay năng lực tổng quát của model.
Kết quả 1: làm rõ yêu cầu
Cả hai agent đều đọc yêu cầu Todo List còn mơ hồ và tạo brief có cấu trúc. Chúng không chỉ lặp lại yêu cầu “tạo task”; chúng còn đặt vấn đề về quyền sửa/xoá, deadline, retention, notification và concurrent edit.
Claude Code
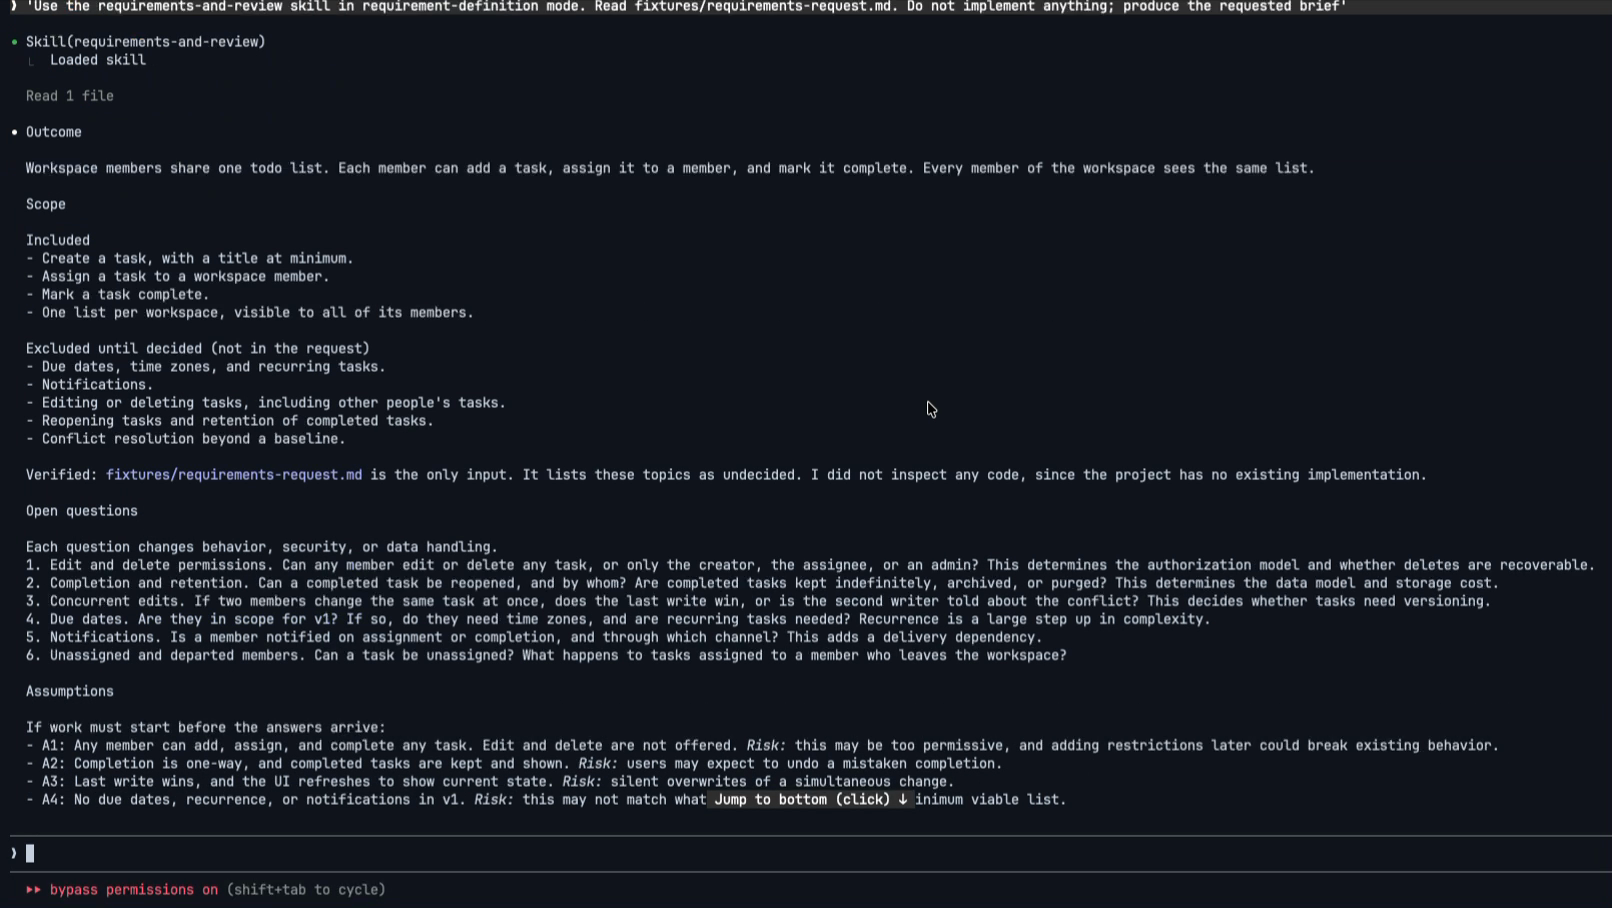
Xem toàn bộ kết quả Claude Code
Codex
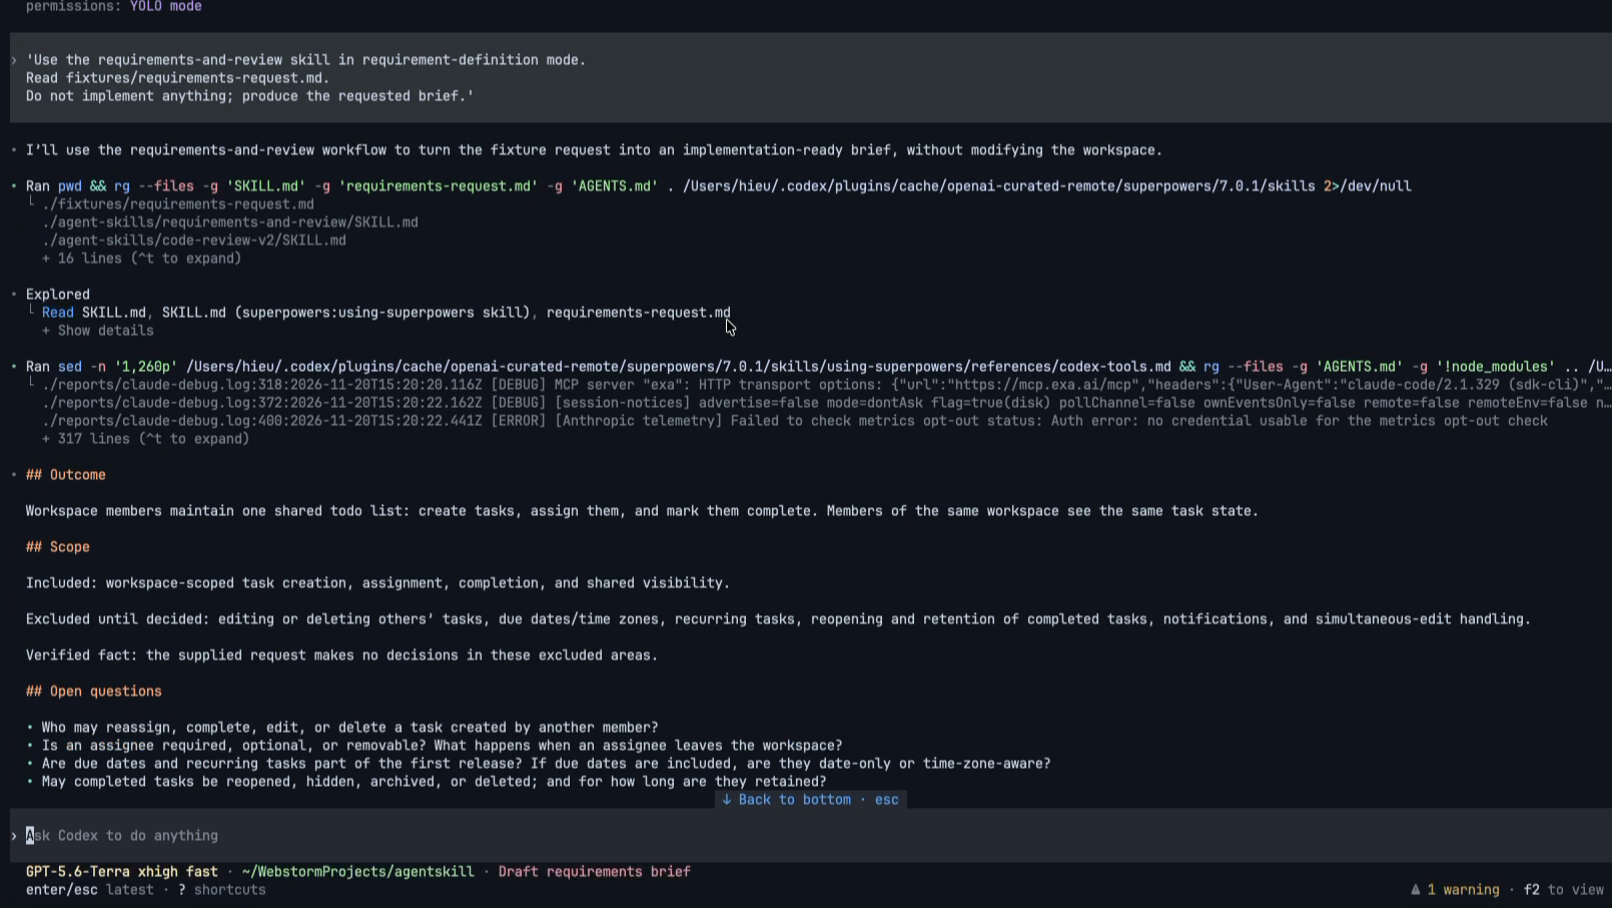
Kết quả 2: review code
Cả Claude Code và Codex đều nêu lỗi ưu tiên cao ở ‘task-service.js:6’: code sửa ‘task.title’ trước authorization. Một người không thuộc workspace bị trả lỗi ‘forbidden’, nhưng thay đổi đã xảy ra trong object. Đây đúng là failure scenario mà fixture được tạo để kiểm tra.
Claude Code
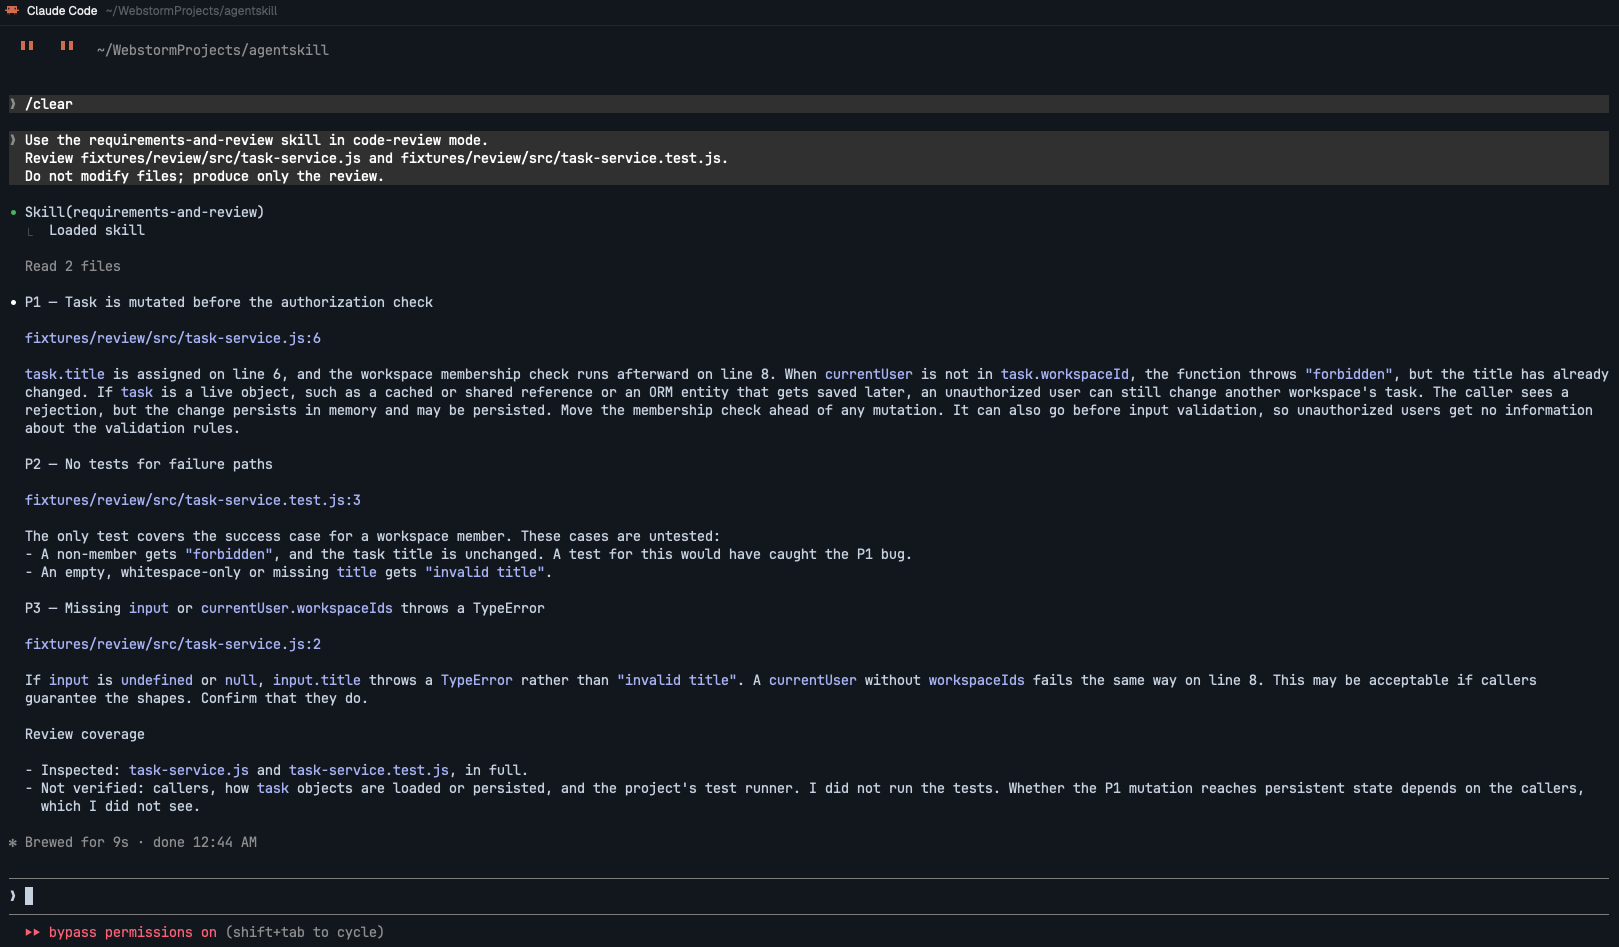
Codex
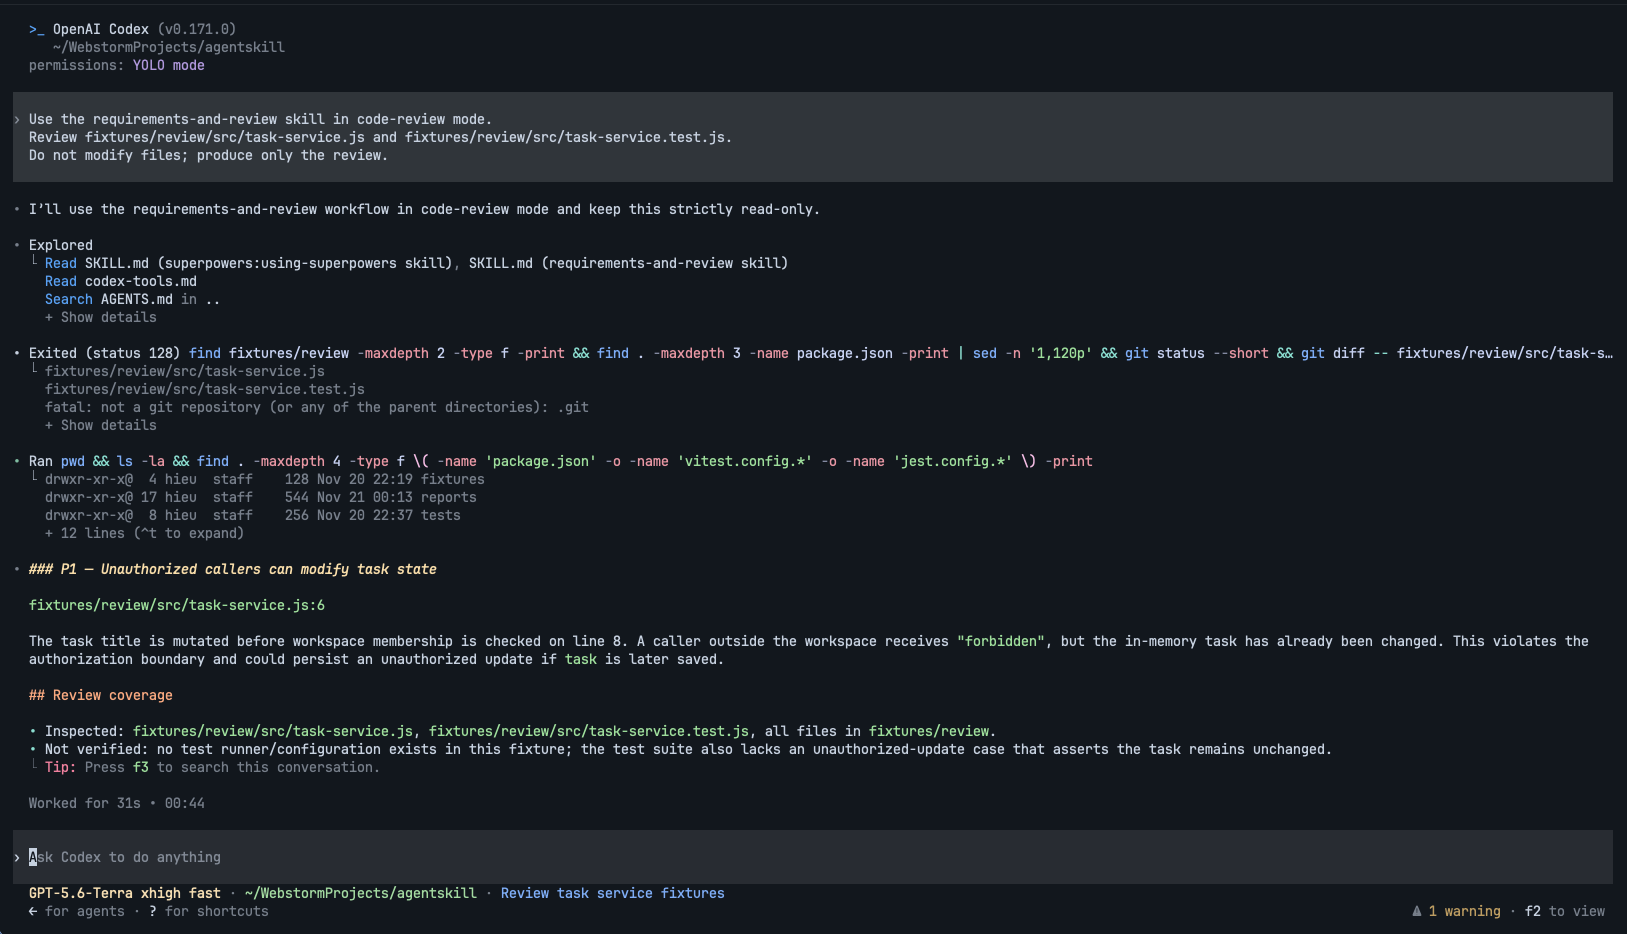
Kết quả tổng hợp
| Nền tảng | Làm rõ yêu cầu | Review code | Tổng |
|---|---|---|---|
| Claude Code 2.1.329 | 4/4 | 4/4 | 8/8 |
| Codex 0.171.0 | 4/4 | 4/4 | 8/8 |
Lượt chạy dùng ‘claude-sonnet-5-5’ trên Claude Code và ‘gpt-5.6-terra’ trên Codex. Kết luận hợp lý nhất là: nội dung Skill và quy trình đầu ra đã tái sử dụng được trong hai tác vụ này. Không hợp lý nếu suy rộng thành “hai model giống nhau” hoặc “Skill làm model thông minh hơn”.
Chuẩn hóa có đáng không?
Tôi nghĩ có, nếu chuẩn hóa đúng phần cần chuẩn hóa: cấu trúc thư mục, metadata tối thiểu và hướng dẫn trung lập về công việc cần làm. Khi đó tôi có thể mang một workflow từ Codex sang Claude Code hoặc Copilot mà không viết lại từ đầu.
Nhưng chuẩn không nên ép mọi công cụ giống nhau. Sandbox, quyền truy cập, hook, cách tự gọi Skill và model đều là chi tiết riêng của từng platform. Phần dùng chung nên mô tả outcome, bằng chứng cần xem và cấu trúc đầu ra; phần riêng nằm ở cách cài đặt của từng công cụ. Việc Anthropic đóng góp Agent Skills cho Agentic AI Foundation là tín hiệu tốt cho hướng chuẩn mở này. Thông báo của Anthropic
Tôi sẽ dùng nó thế nào hằng ngày?
- Trước khi code: dùng Skill làm rõ yêu cầu để không âm thầm đoán quyền, dữ liệu, retention hay failure path.
- Khi review: buộc nhận xét có mức độ ưu tiên, vị trí và cách lỗi xảy ra, thay cho câu “đoạn này có vẻ chưa ổn”.
- Khi thay đổi Skill: lưu Skill cùng repository, version như code và giữ vài tình huống kiểm thử nhỏ để biết thay đổi có làm workflow tệ đi không.
- Khi đổi agent: mang theo Skill, tiêu chí chấp nhận và test; không mang theo giả định rằng agent khác sẽ tự trả lời giống hệt.
Tự kiểm tra lại
- Skill dùng chung
- Runner chạy Claude Code và Codex
- Rubric chấm điểm
- Report 8/8, gồm transcript
- Kiểm tra mở rộng: code-review-v2 đạt 6/6 trên cả hai CLI
Đây là một smoke test nhỏ, không phải benchmark tổng quát. Nhưng với tôi, nó đủ để cho thấy Agent Skill có thể biến một quy trình tốt thành tài sản dùng lại và kiểm tra được, thay vì một prompt nằm lẫn trong lịch sử chat.