1. Introduction
Khi sử dụng các hệ thống AI hiện đại, đặc biệt là LLM agents, khả năng tìm đúng thông tin rất quan trọng. Một AI có thể suy luận tốt nhưng nếu hệ thống retrieval đưa sai tài liệu hoặc không tìm được thông tin liên quan thì kết quả cuối cùng vẫn có thể không chính xác.
Một trong những thành phần quan trọng của hệ thống retrieval là index.
Có thể hình dung đơn giản:
Document → Index → Retriever → Relevant information → LLM/Agent
Index không chỉ đơn giản là lưu tài liệu. Nó cần có những index keys giúp hệ thống nhận biết tài liệu nào có khả năng chứa thông tin phù hợp với câu hỏi.
Vấn đề là cách biểu diễn một tài liệu hiệu quả không phải lúc nào cũng giống nhau. Một cách xây dựng index có thể hoạt động tốt với tài liệu text nhưng lại không tốt với code, mathematics hoặc table. Paper “Self-Evolving Search Index” đề xuất một hướng tiếp cận mới: để chính index có khả năng tự phát hiện vấn đề, tự sửa representation và tự kiểm tra kết quả.
2. Vấn đề mà nghiên cứu muốn giải quyết
Các phương pháp index optimization trước đây thường cần con người tham gia.
Khi retrieval không tốt, con người phải:
- Phân tích tại sao tài liệu không được retrieve đúng.
- Xác định index key có vấn đề.
- Thiết kế hoặc điều chỉnh strategy.
- Tạo lại index.
- Kiểm tra lại kết quả.
Quá trình này phải lặp lại khi xuất hiện các loại query mới.
Điều này trở thành bottleneck khi corpus lớn và nhu cầu tìm kiếm thay đổi liên tục. Paper hướng tới việc tự động hóa vòng lặp này.
3. Self-Index là gì?
Self-Index là framework cho phép index tự phát triển theo retrieval environment.
Điểm quan trọng là hệ thống không thay đổi nội dung gốc của document.
Thay vào đó, nó thay đổi cách document được biểu diễn thông qua các index keys.
Framework có hai thành phần chính:
1. Optimizer
Optimizer chịu trách nhiệm:
Self-Diagnosis → Self-Revision → Self-Validation
2. Query Simulator
Query Simulator tạo ra những query mới để hệ thống có thể khám phá những nhu cầu tìm kiếm chưa xuất hiện trong dữ liệu query hiện tại.
Hai thành phần này kết hợp với nhau tạo thành một vòng lặp:
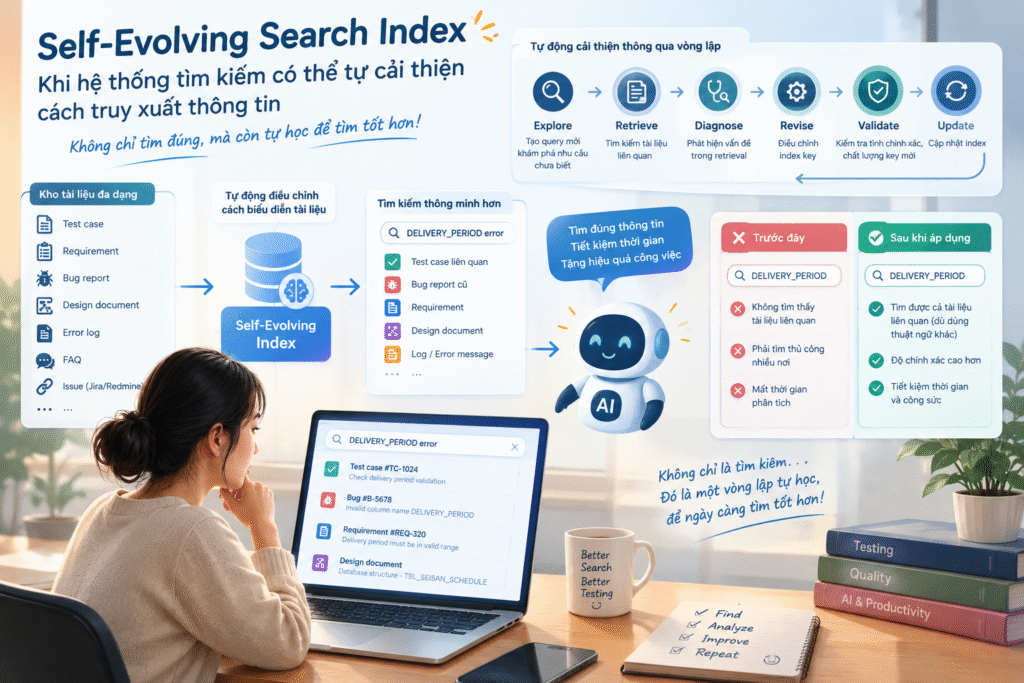
Explore → Retrieve → Diagnose → Revise → Validate → Update → Explore again
4. Self-Diagnosis – Tự phát hiện vấn đề
Bước đầu tiên của Optimizer là tìm ra index đang gặp vấn đề ở đâu.
Khi nhận một nhóm query, hệ thống chạy retrieval và xem những key nào được retrieve.
Sau đó, Self-Index tạo ra một khái niệm gọi là co-retrieval profile.
Hiểu đơn giản, hệ thống quan sát:
“Khi key A được retrieve, những key nào khác thường xuất hiện cùng?”
Thông tin này giúp hệ thống nhận biết liệu một key có đang biểu diễn tài liệu đủ rõ ràng hay không.
Điểm đáng chú ý là quá trình này không cần manually annotated relevance labels. Optimizer có thể sử dụng retrieval outcomes để tự chẩn đoán vấn đề.
5. Self-Revision – Tự sửa index
Sau khi phát hiện vấn đề, hệ thống không đơn giản tạo thêm thật nhiều keywords.
Optimizer xem xét toàn bộ key set của document và quyết định:
- Key nào nên giữ lại?
- Key nào cần thay đổi?
- Cần tạo key mới nào?
- Representation cần tập trung vào thông tin nào?
Điểm đáng chú ý là các key của cùng một document được xem xét jointly, tránh việc tạo ra quá nhiều representation trùng lặp.
Paper đặt giới hạn tối đa 10 keys cho một document trong implementation được mô tả.
6. Self-Validation – Không phải revision nào cũng được chấp nhận
Đây là phần mình thấy rất quan trọng.
Nếu AI tự tạo index key mà không có bước kiểm tra, hệ thống có thể tạo ra những representation nghe có vẻ hợp lý nhưng không thực sự tốt cho retrieval.
Self-Index vì vậy kiểm tra mỗi generated key theo ba tiêu chí:
① Faithfulness
Key có phản ánh đúng thông tin trong document không?
Nói đơn giản:
Không được tạo ra thông tin mà document không hỗ trợ.
② Specificity
Key có thể hiện thông tin đặc trưng của document đó không?
Nếu key quá chung chung và phù hợp với rất nhiều document khác, nó sẽ không giúp retrieval phân biệt tốt.
③ Separation
Key mới có giúp document nổi bật hơn so với những representation cạnh tranh không?
Nếu key mới không cải thiện khả năng phân biệt document, nó có thể bị loại bỏ.
Đặc biệt, kết quả ablation cho thấy việc bỏ toàn bộ validation khiến hiệu quả retrieval giảm mạnh; trong thử nghiệm, điểm nDCG@10 thậm chí thấp hơn base index trên cả ba nhóm corpus được phân tích.
7. Query Simulator – Cho index tự khám phá nhu cầu mới
Nếu chỉ phản ứng với những query đã xuất hiện, index vẫn có một giới hạn:
Nó chỉ biết cải thiện những vấn đề mà nó đã nhìn thấy.
Self-Index giải quyết vấn đề này bằng Query Simulator.
Query Simulator lấy các document trong corpus và tạo ra những query thể hiện những nhu cầu tìm kiếm có thể xảy ra.
Sau đó hệ thống dùng Dissimilarity filter để loại bỏ những query quá giống với query đã sử dụng trước đó.
Những query mới được đưa trở lại Optimizer để tiếp tục cải thiện index.
Đây là điểm làm cho Self-Index không chỉ reactive mà còn có khả năng proactive self-evolution.
8. Tổng thể kiến trúc
Có thể hình dung Self-Index như sau:
                 ┌─────────────────────┐
                 │      Documents      │
                 └──────────┬──────────┘
                            ↓
                    Initial Index
                            ↓
                  ┌──────────────────┐
                  │     Retriever    │
                  └────────┬─────────┘
                           ↓
                    Retrieval Results
                           ↓
              ┌─────────────────────────┐
              │      Self-Diagnosis     │
              │  Find retrieval issues  │
              └────────────┬────────────┘
                           ↓
              ┌─────────────────────────┐
              │      Self-Revision      │
              │  Revise index keys      │
              └────────────┬────────────┘
                           ↓
              ┌─────────────────────────┐
              │     Self-Validation     │
              │ Faithfulness            │
              │ Specificity             │
              │ Separation              │
              └────────────┬────────────┘
                           ↓
                     Updated Index
                           ↑
                           │
              ┌────────────┴────────────┐
              │     Query Simulator     │
              │    Self-Exploration     │
              └─────────────────────────┘
Điểm quan trọng nhất là index không được cải thiện chỉ một lần. Nó tiếp tục trải qua nhiều iteration và các revision hợp lệ được tích lũy dần.
9. Kết quả thực nghiệm
Paper đánh giá Self-Index trên nhiều loại dữ liệu:
- Natural language
- Code
- Mathematics
- Tables
Các benchmark chính gồm BRIGHT, ba dataset cho table retrieval, BrowseComp-Plus cho search agents và LongMemEval-V2 cho agent memory. Metric retrieval chính là nDCG@10.
Self-Index được so sánh với các phương pháp như:
- Doc2Query
- SPIKE
- RL-Index
- EnrichIndex
và được đánh giá với các retriever như:
- BM25
- BGE-Large
- Qwen3-Embedding-8B.
10. Retrieval performance
Kết quả nổi bật là Self-Index đạt average nDCG@10 cao nhất trên BRIGHT đối với các retriever được đánh giá.
Ví dụ:
| Retriever | Base | Self-Index | Relative improvement |
|---|---|---|---|
| BM25 | 14.5 | 20.4 | +40.4% |
| BGE | 13.9 | 21.8 | +57.0% |
| Qwen3-Emb-8B | 18.8 | 26.1 | +38.8% |
Trên table retrieval, Self-Index cũng đạt mức cải thiện đáng kể. Với BM25, average score tăng từ 33.2 lên 49.5, tương đương +49.1%.
Điểm đáng chú ý không chỉ là con số tăng, mà là tính ổn định: một số phương pháp khác có thể cải thiện một loại corpus nhưng lại làm giảm performance ở môi trường khác. Self-Index hướng tới việc thích nghi với từng retrieval environment thay vì áp dụng một strategy cố định cho tất cả.
11. Search Agent cũng được hưởng lợi
Một câu hỏi quan trọng là:
Nếu retrieval tốt hơn thì search agent có thực sự làm việc tốt hơn không?
Paper thử nghiệm với BrowseComp-Plus và nhiều agent backbones, trong đó có GPT-OSS-120B, GPT-5.4-nano, Gemini-3.7-Flash và Kimi-K2.5.
Ví dụ với GPT-5.4-nano + BM25:
- Base accuracy: 36.51
- Self-Index accuracy: 64.94
- Improvement: +77.87%
Đồng thời số search calls giảm từ 19.23 xuống 16.00, tức giảm khoảng 16.8%.
Điều này rất đáng chú ý vì cải thiện retrieval không chỉ giúp agent trả lời chính xác hơn mà còn có thể giảm số lần phải gọi search, từ đó giảm online cost.
12. Self-Index và Agent Memory
Một ứng dụng khác là AI memory.
Agent có thể lưu lại các interaction trong quá khứ. Nhưng việc lưu dữ liệu thôi chưa đủ.
Nếu agent không thể tìm lại đúng memory khi cần, dữ liệu đó gần như không có giá trị.
Self-Index thử nghiệm bằng cách chỉ thay đổi index keys, không thay đổi nội dung memory.
Kết quả cho thấy accuracy của tất cả các memory systems được thử nghiệm đều tăng. Ví dụ:
- Query → Slice: +13.9%
- Query → Slice + Notes: +12.4%
- AgentRunbook-R: +9.2%
Điều này cho thấy đôi khi vấn đề không nằm ở “AI có bao nhiêu memory”, mà nằm ở “AI có tìm đúng memory hay không”.
13. Điều gì thực sự tạo ra hiệu quả?
Phần ablation study cho thấy các thành phần của Self-Index đều có vai trò.
Khi bỏ:
- co-retrieval profile;
- Self-Validation;
- Faithfulness;
- Specificity;
- Separation;
- Dissimilarity filter;
performance đều giảm ở các corpus được đánh giá.
Đặc biệt, khi bỏ Self-Validation hoàn toàn, kết quả giảm rất mạnh.
Điều này cho thấy một lesson quan trọng:
Một hệ thống AI tự cải thiện không chỉ cần khả năng “tạo ra thay đổi”, mà còn cần khả năng đánh giá xem thay đổi đó có thực sự tốt hay không.
14. Personal Learnings
Điểm mình thấy thú vị nhất từ nghiên cứu này là cách tiếp cận “AI tự cải thiện thông qua feedback”.
Thông thường, mình có thể nghĩ đơn giản:
AI → Answer → Done
Nhưng Self-Index cho thấy một workflow mạnh hơn:
Result → Detect problem → Improve → Validate → Try again
Điều này rất gần với cách mình làm testing.
Trong testing cũng không phải cứ tạo testcase rồi chạy một lần là kết thúc. Khi phát hiện defect hoặc missed scenario, mình cần:
Test result → Analyze failure → Update test case → Re-test → Regression
Vì vậy, mình thấy ý tưởng của Self-Index có thể áp dụng khá tốt vào các workflow hiện tại của mình.
15. Áp dụng vào công việc Software Testing
15.1. Requirement → Test case retrieval
Trong một project lớn, số lượng requirement và testcase có thể rất nhiều.
Khi mình hỏi:
“Tìm những testcase liên quan đến chức năng quotation.”
một hệ thống retrieval tốt cần tìm đúng testcase, kể cả khi testcase không chứa chính xác từ “quotation”.
Có thể áp dụng tư duy của Self-Index:
Requirement
     ↓
Existing Test Cases
     ↓
Index
     ↓
Search Query
     ↓
Retrieved Test Cases
     ↓
Evaluate result
     ↓
Improve index representation
Nếu hệ thống liên tục nhận ra những testcase liên quan nhưng chưa được retrieve, index có thể được cải thiện để lần sau tìm tốt hơn.
16. Áp dụng cho Bug Analysis
Mình cũng có thể áp dụng ý tưởng này cho bug history.
Ví dụ project có hàng nghìn bug:
Bug #001
Bug #002
Bug #003
...
Bug #5000
Khi gặp bug mới, mình muốn tìm những bug tương tự.
Một hệ thống retrieval có thể sử dụng:
- Bug title
- Description
- Steps
- Error message
- Screen
- Module
- Root cause
để tìm historical bugs.
Nếu kết quả retrieval không tốt, hệ thống có thể học cách biểu diễn bug tốt hơn.
Điều này có thể giúp mình nhanh chóng tìm:
“Bug này đã từng xảy ra chưa?”
hoặc:
“Có bug nào có root cause tương tự không?”
17. Áp dụng cho tài liệu dự án
Trong công việc của mình có rất nhiều loại tài liệu:
- Requirement
- Test specification
- Test case
- Bug report
- Meeting notes
- Design document
- Release information
Nếu xây dựng một hệ thống AI assistant cho tester, mình muốn có workflow:
Tester Question
      ↓
Search Project Knowledge
      ↓
Retrieve Relevant Documents
      ↓
AI Analysis
      ↓
Answer + Source
Điểm quan trọng là retrieval phải chính xác trước khi AI đưa ra câu trả lời.
Nếu retrieval sai, dù LLM rất mạnh thì output vẫn có thể sai.
Đây là lý do mình thấy ý tưởng Self-Index có tính thực tế cao đối với các hệ thống AI hỗ trợ công việc.
18. Một workflow mình muốn áp dụng
Nếu áp dụng trực tiếp vào công việc testing, mình có thể xây dựng một workflow tương tự:
Project Documents
       ↓
Create Index
       ↓
Tester asks question
       ↓
Retrieve documents
       ↓
Check retrieval quality
       ↓
Identify missing / wrong results
       ↓
Improve index keys
       ↓
Validate
       ↓
Update index
       ↓
Next query
Về lâu dài, hệ thống có thể trở nên tốt hơn mà không cần mỗi lần đều phải manually chỉnh toàn bộ index.
19. Kết luận
Self-Evolving Search Index đưa ra một cách tiếp cận thú vị đối với Information Retrieval: thay vì coi index là một thành phần được xây dựng một lần rồi giữ nguyên, hệ thống có thể liên tục tiến hóa dựa trên retrieval feedback và những nhu cầu tìm kiếm mới.
Ba bước cốt lõi của Optimizer là:
Self-Diagnosis → Self-Revision → Self-Validation
và Query Simulator bổ sung khả năng:
Self-Exploration
Kết quả thực nghiệm cho thấy Self-Index cải thiện retrieval trên nhiều loại dữ liệu, đồng thời giúp search agents tăng accuracy, giảm số search calls và cải thiện việc sử dụng agent memory.
Điều mình rút ra và muốn áp dụng vào công việc không phải là xây dựng ngay một hệ thống Self-Index hoàn chỉnh, mà là học cách thiết kế workflow theo vòng lặp:
Thực hiện → đo kết quả → tìm vấn đề → cải thiện → kiểm tra lại.
Đây cũng chính là cách mình có thể kết hợp AI + testing + feedback loop để giảm các thao tác tìm kiếm thủ công và nâng cao hiệu quả trong công việc hàng ngày.
Nguồn: Self-Evolving Search Index, Sangam Lee et al., arXiv:2609.19656, 2026.