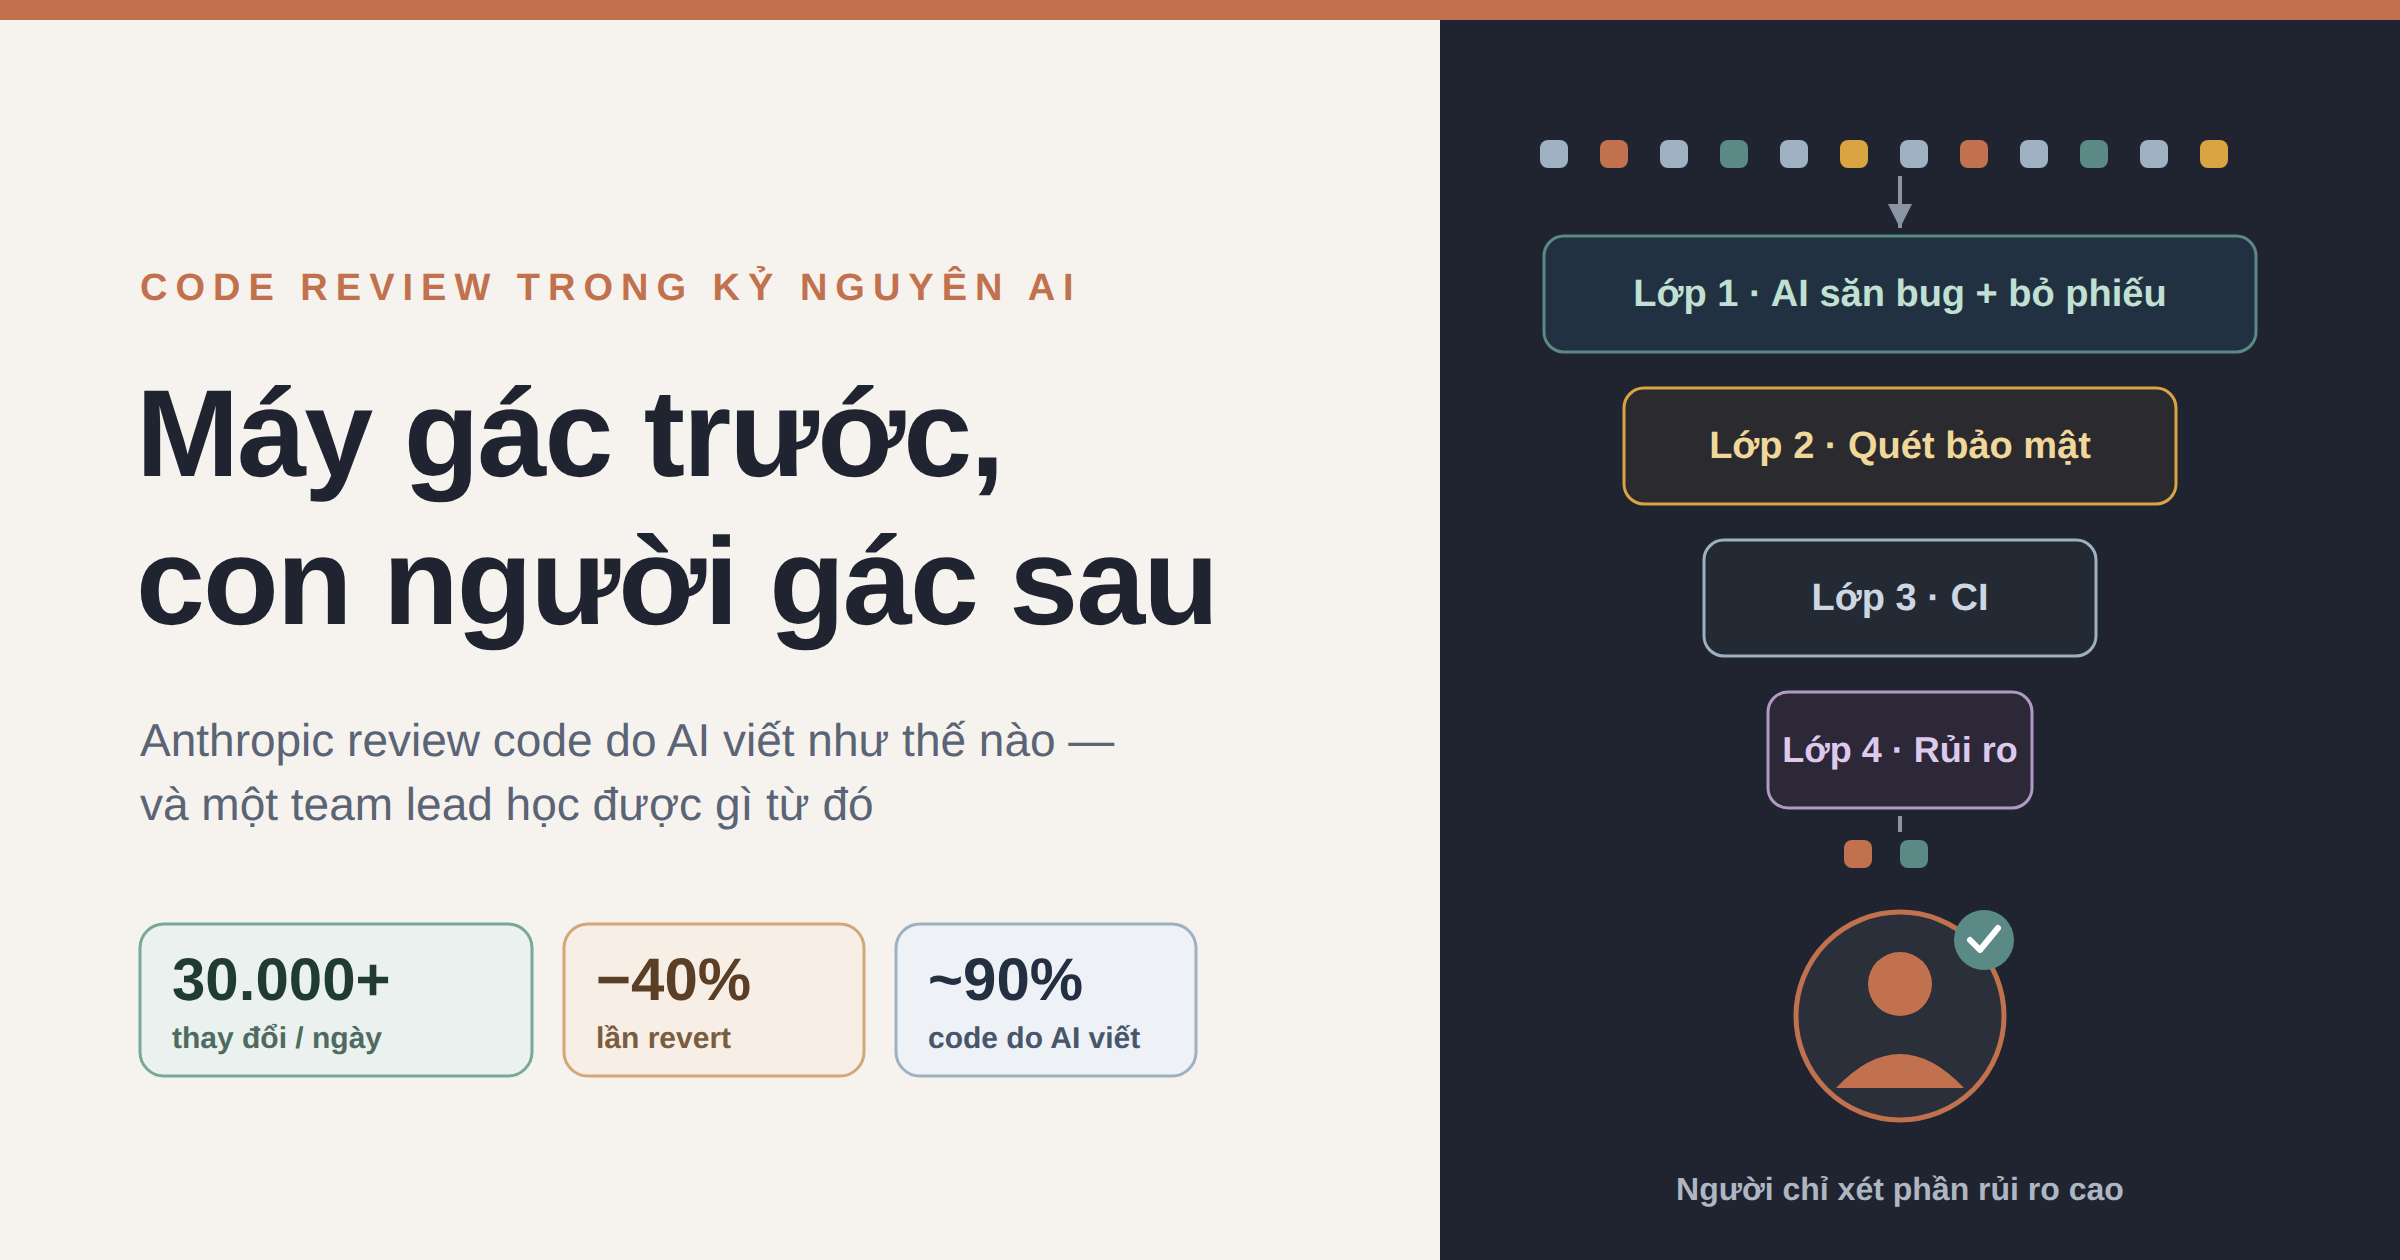
Hãy tưởng tượng công ty bạn đang xử lý 2.500 thay đổi code mỗi ngày. Rồi bạn cho AI viết code. Vài tháng sau, con số đó thành hơn 30.000 thay đổi mỗi ngày — gấp khoảng 12 lần.
Viết code không còn là nút thắt. Giờ nút thắt là: làm sao chứng minh đống code đó đúng?
Cách cũ — một người ngồi đọc từng dòng diff rồi gật đầu — vốn đã chậm. Giờ máy đẻ code nhanh hơn tốc độ bất kỳ ai đọc kịp, nên cái “cổng một người gác” đơn giản là vỡ trận.
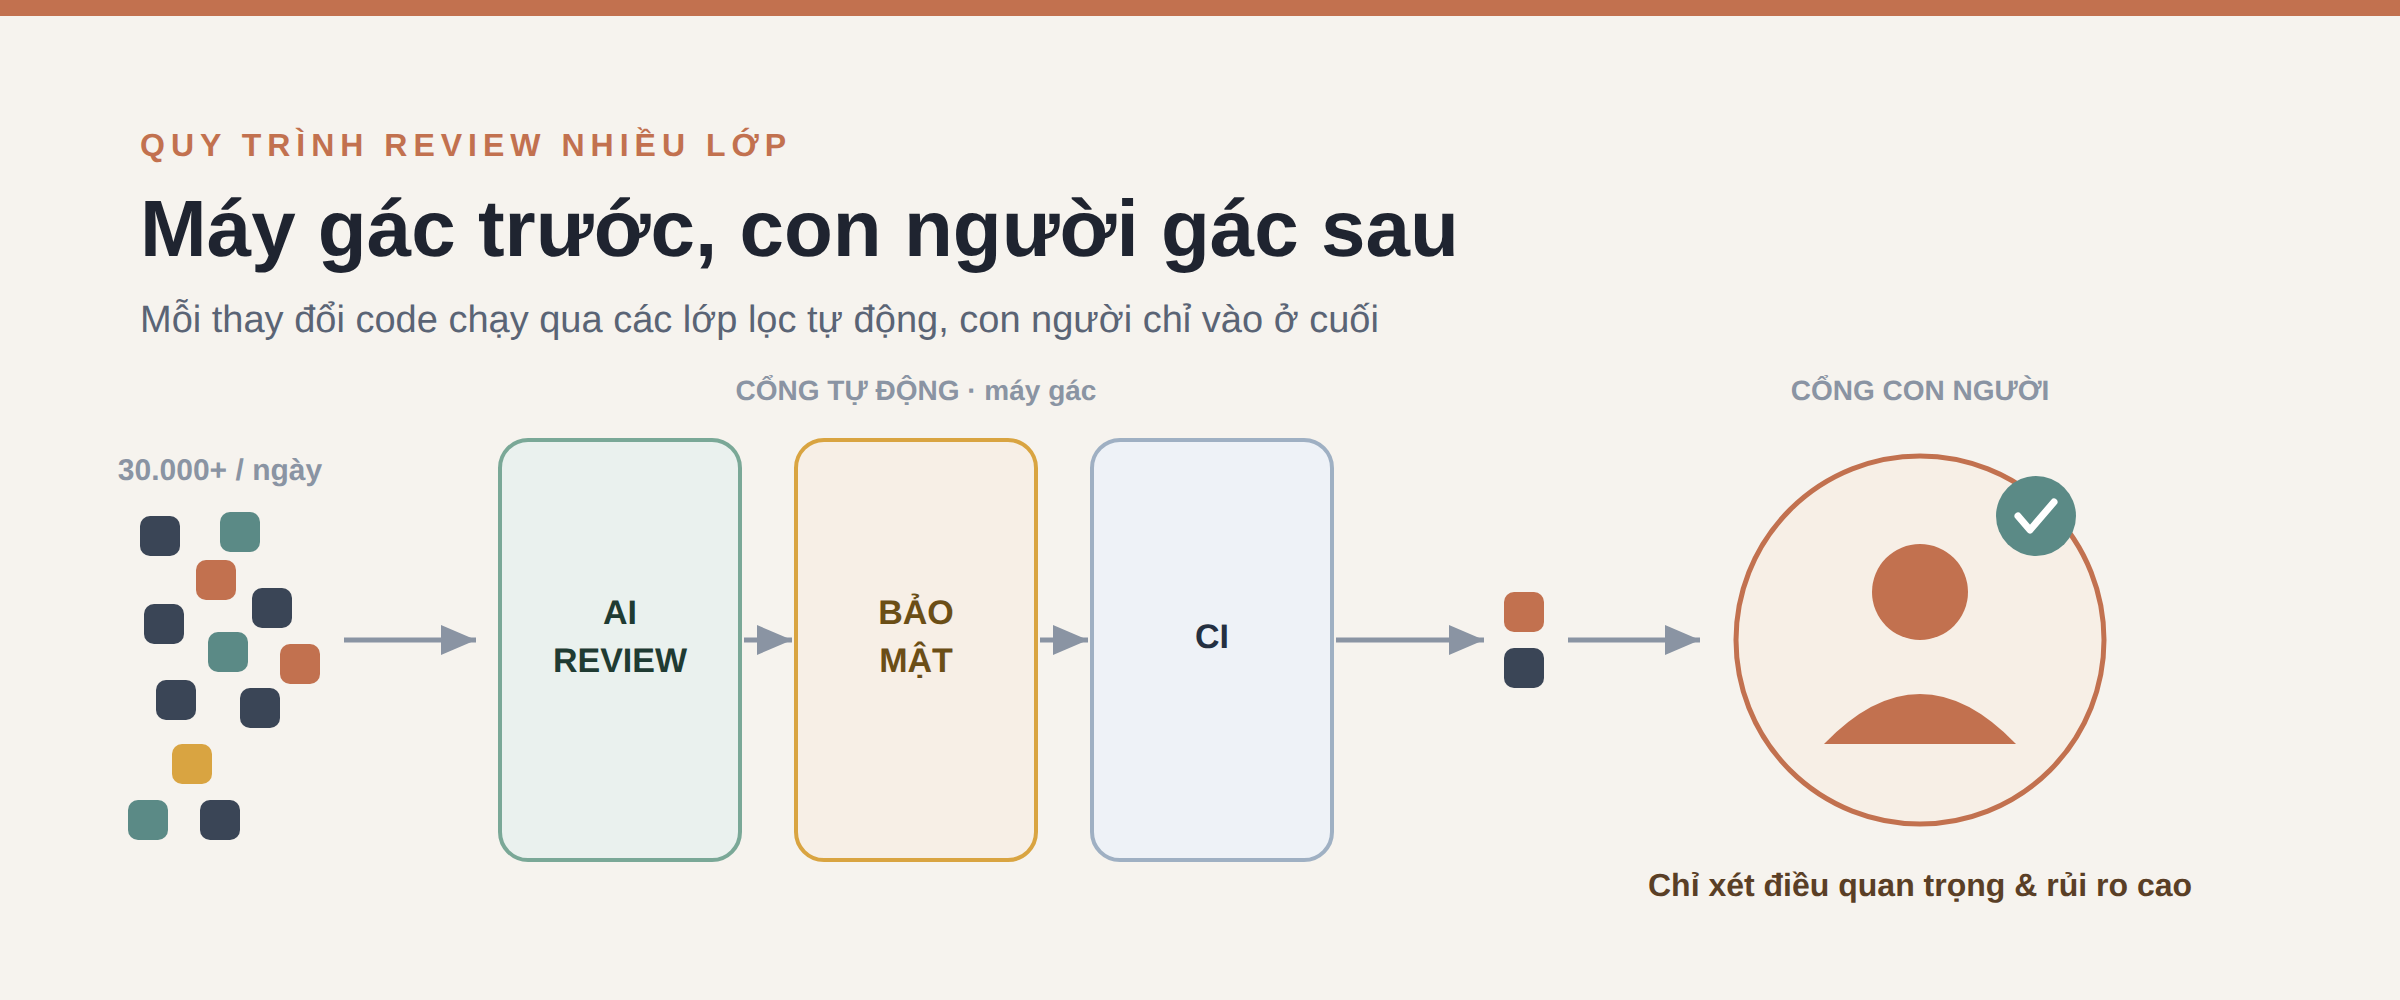
Điều thú vị là nhóm Claude Code của Anthropic không giải quyết bằng cách thuê thêm người đọc. Họ xây lại cái cổng thành một dây chuyền nhiều lớp lọc, trong đó máy làm phần lớn, còn con người chỉ được gọi vào đúng chỗ thật sự cần. Bài này mình sẽ kể lại cách dây chuyền đó hoạt động, rồi chia sẻ góc nhìn của một người làm vai trò lead/reviewer về chuyện áp dụng nó vào đời thực.
Toàn cảnh: một PR phải đi qua những cửa nào?
Hãy hình dung mỗi thay đổi code như một kiện hàng chạy trên băng chuyền. Nó phải qua lần lượt các trạm kiểm tra:
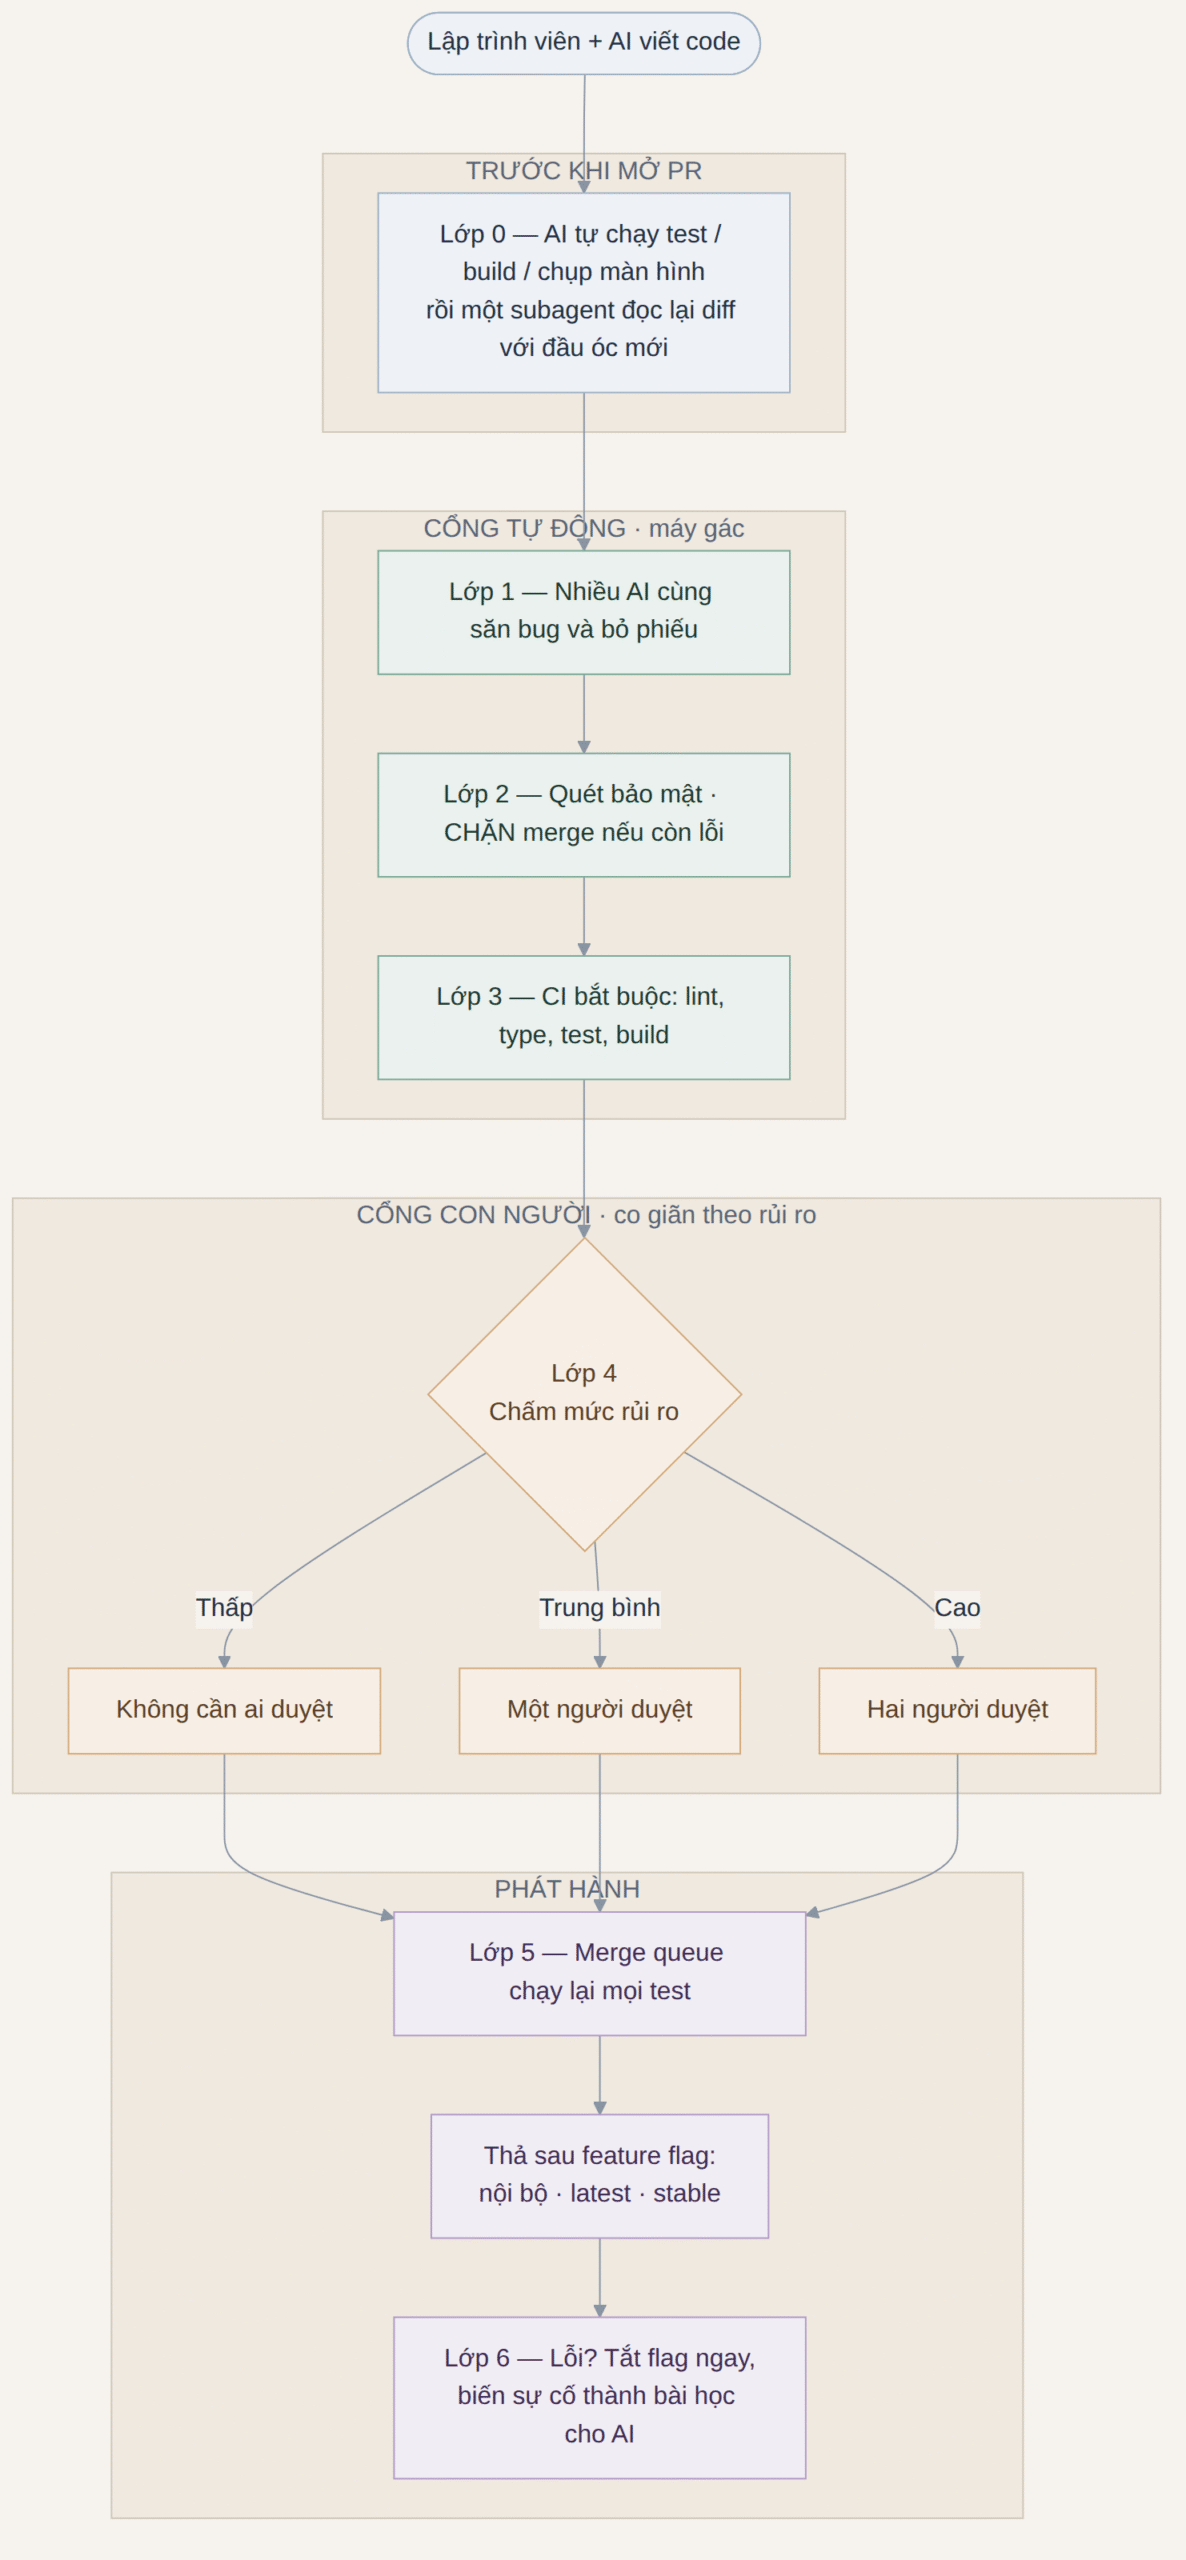
Ý tưởng cốt lõi: không đặt một cổng ở cuối, mà rải nhiều lớp lọc dọc đường đi. Con người là lớp cuối cùng, không phải lớp duy nhất.
Mổ xẻ từng lớp
Lớp 0 — Tự kiểm trước khi làm phiền người khác
Trước khi ai nhìn vào code, AI phải tự chứng minh mình làm đúng đã. Nó được đưa cho một thứ chạy được để tự kiểm:
| Loại thay đổi | Cách AI tự kiểm chứng |
|---|---|
| Logic / hàm | Chạy test, chạy build |
| Giao diện | Chụp màn hình so với bản thiết kế |
| Luồng người dùng | Mở app trong trình duyệt / giả lập điện thoại |
| Thay đổi nhỏ | Chỉ cần một lệnh bash |
Sau đó, một AI khác (subagent) đọc lại diff bằng “đầu óc mới” — không dính vào mạch suy nghĩ lúc viết, nên dễ thấy lỗi hơn. Giống như nhờ đồng nghiệp đọc giúp email trước khi bấm gửi.
Lớp 1 — Nhiều AI cùng săn bug rồi bỏ phiếu
Mỗi PR được một reviewer AI đọc, đối chiếu với cả repo và với ý định của PR: “thay đổi này có giải quyết đúng việc của nó không? Có làm hỏng thứ đang chạy không?” Hay nhất là cơ chế săn bug tập thể cộng bỏ phiếu lọc nhiễu:
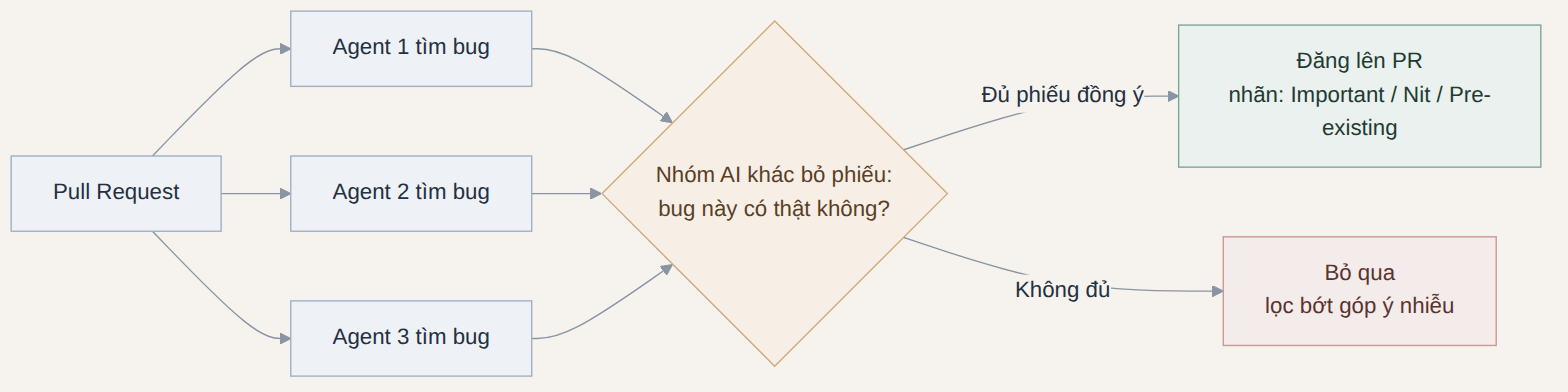
Nhờ vậy con người không bị ngập trong hàng trăm comment vớ vẩn — chỉ thấy những gì nhiều AI đồng ý là thật. Kết quả: tỉ lệ PR nhận comment có chất tăng từ 16% lên 54%.
Lớp 2 — Bảo mật: còn lỗi là khóa cứng
Bảo mật có lượt quét riêng. Quy tắc cứng rắn:
Còn một lỗi đang mở (dù từ review code hay bảo mật) thì không được merge. Chấm hết.
Tác giả buộc phải sửa, hoặc giải thích và đóng luồng thảo luận. Không có cửa “thôi kệ merge trước, sửa sau”.
Lớp 3 — CI bắt buộc
Mấy kiểm tra tiêu chuẩn chặn merge: lint, type-check, test, build. Thêm một điểm hay: PR phải ghi rõ đã test thế nào và nếu hỏng thì lùi lại ra sao. Tức là nghĩ tới đường lui ngay từ đầu, không phải lúc cháy nhà mới cuống.
Lớp 4 — Con người duyệt, nhưng co giãn theo rủi ro
Đây là phần thông minh nhất. Máy (classifier) tự chấm mức rủi ro, không để tác giả tự khai (vì ai cũng nghĩ code mình an toàn):
| Mức rủi ro | Ví dụ | Cần mấy người duyệt? |
|---|---|---|
| Thấp | Tài liệu, sửa chữ, tính năng nội bộ, phần nấp sau flag | 0 (nếu máy pass hết) |
| Trung bình | Thay đổi sản phẩm thường; vùng nhạy cảm (caching, auto-update, prompt) | 1 người |
| Cao | Code rủi ro nhất; đường dẫn được đánh dấu nhạy cảm | 2 người |
Vài luật đi kèm đáng ghi nhớ:
- AI duyệt không thay được chữ ký người bắt buộc.
- Người “ra lệnh” cho AI được tính là 1 reviewer.
- Một lần duyệt chỉ có giá trị cho đúng 1 commit (sửa thêm thì duyệt lại).
- Chỉ tác giả đáng tin mới đi được đường duyệt nhẹ.
Lớp 5 và 6 — Phát hành theo bậc và lùi siêu nhanh

Mỗi lần có sự cố hay revert, họ biến nó thành một case học tập để con reviewer AI ngày càng ít sai.
Mấy “van an toàn” chống AI cãi nhau vô tận
| Vấn đề có thể xảy ra | Cách họ chặn |
|---|---|
| AI và tác giả sửa qua sửa lại mãi | Giới hạn 3 vòng rồi buộc xem lại cả cách làm |
| Review lại từ đầu tốn công | Sau vòng đầu chỉ xem phần diff mới |
| Cùng một loại lỗi rải khắp nơi | Gắn nhãn lớp lỗi, tác giả sửa hết một lượt |
| Lải nhải lặp lại | Không nhắc lại phát hiện đã nêu |
Kết quả ra sao?
Số liệu nội bộ của Anthropic trong khoảng tháng 5 đến tháng 9:
- Số PR được merge: tăng hơn 2 lần.
- Tỉ lệ bị revert: giảm hơn 40%.
- AI reviewer bị kỹ sư đánh dấu là sai: dưới 1%.
- PR pass ngay sau 1 vòng review: tăng từ 65% lên 78%.
- PR phải quay 5 vòng trở lên: giảm từ 8,9% xuống 1,5%.
- Số vòng trung bình để pass: giảm từ 2,08 xuống 1,32.
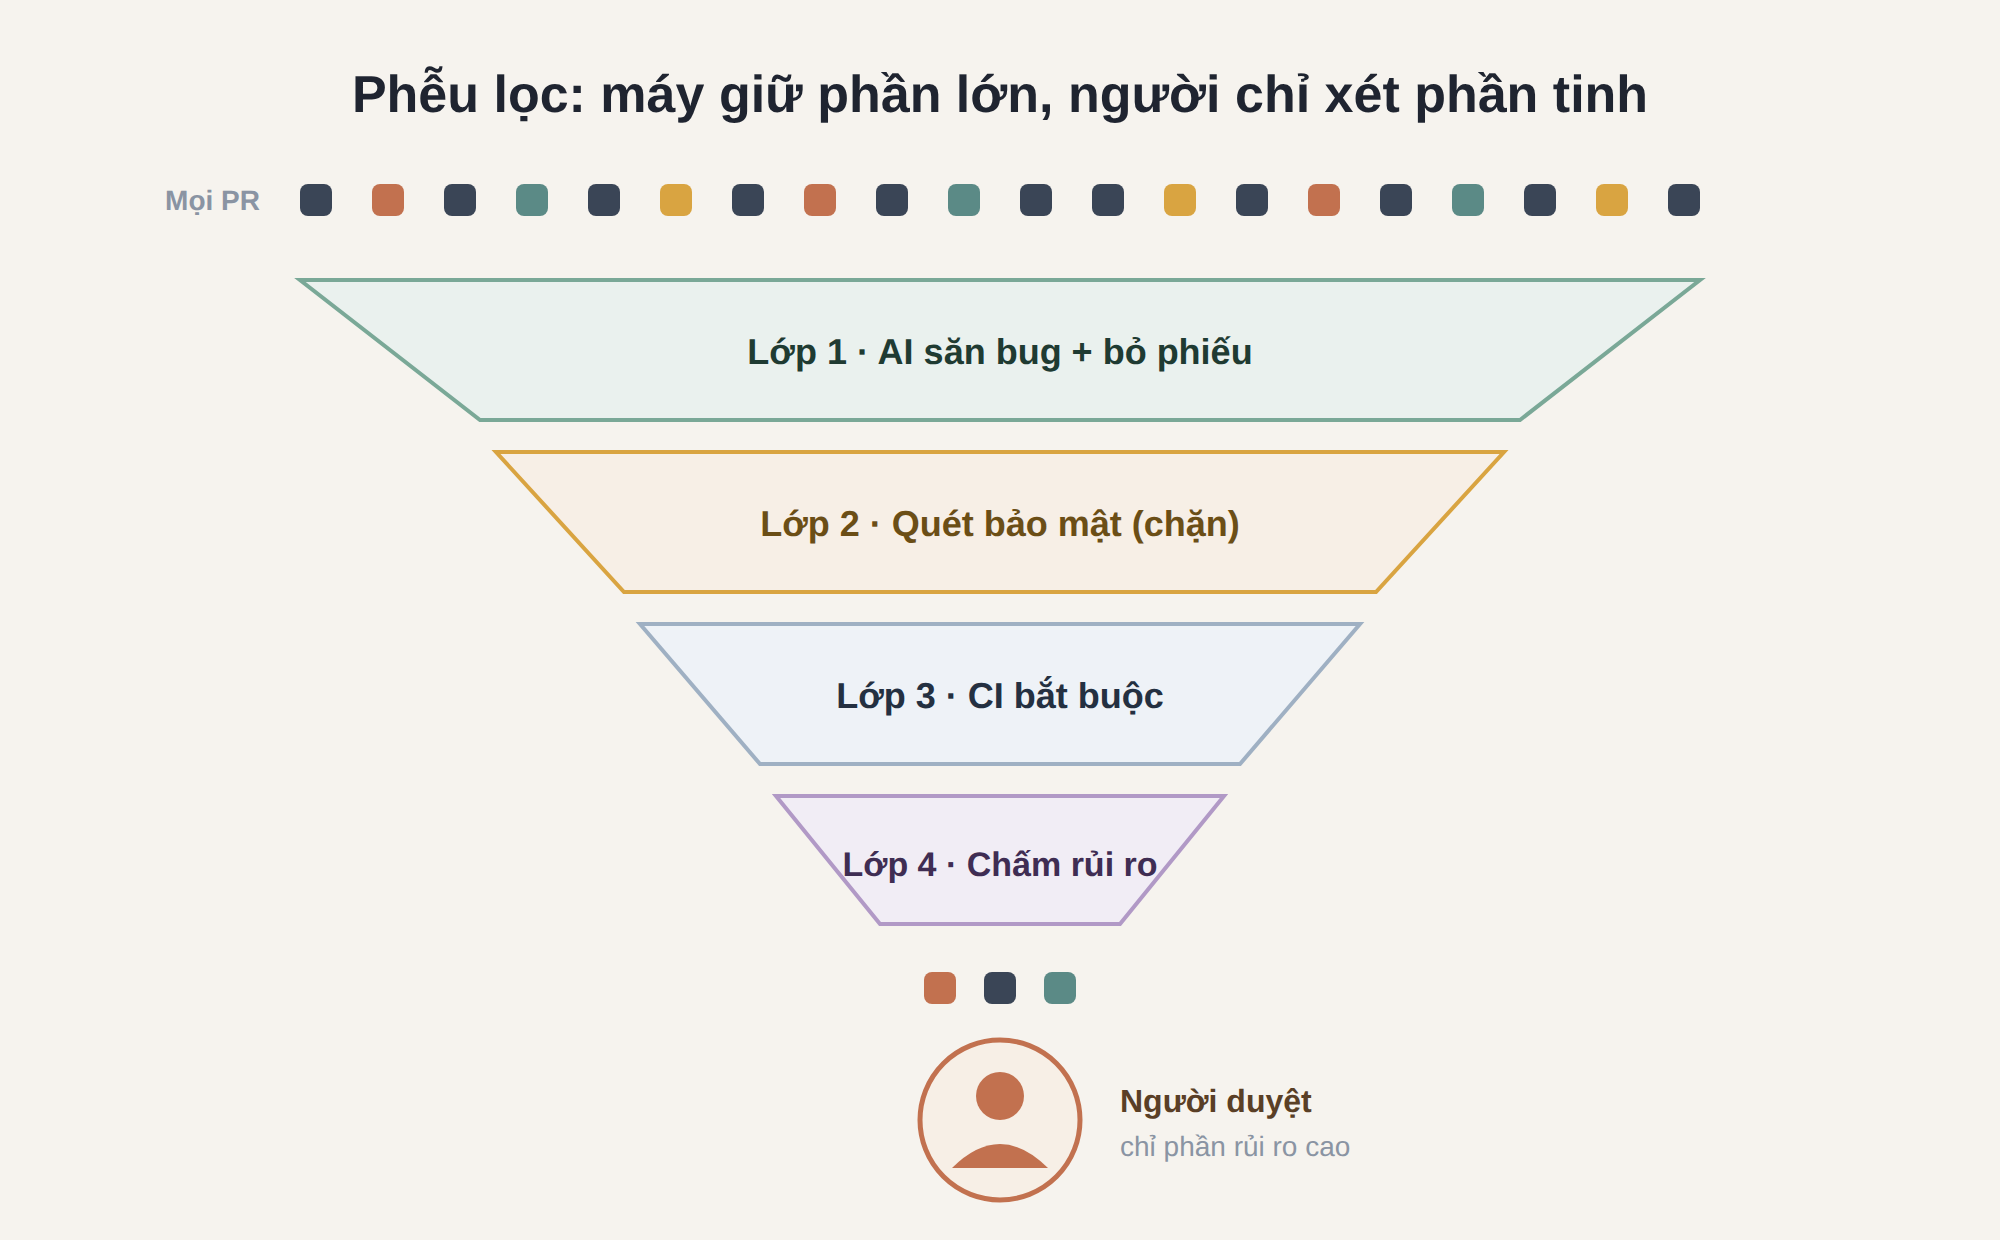
Lưu ý: đây là số Anthropic tự công bố trong bối cảnh riêng của họ, chưa ai kiểm chứng độc lập. Nên đọc theo hướng xu hướng chứ đừng coi là chân lý phổ quát.
Chi tiết quan trọng nhất: con người được dời đi đâu?
Điểm hay nhất không phải “AI thay con người”. Mà là họ định nghĩa lại việc con người nên làm.
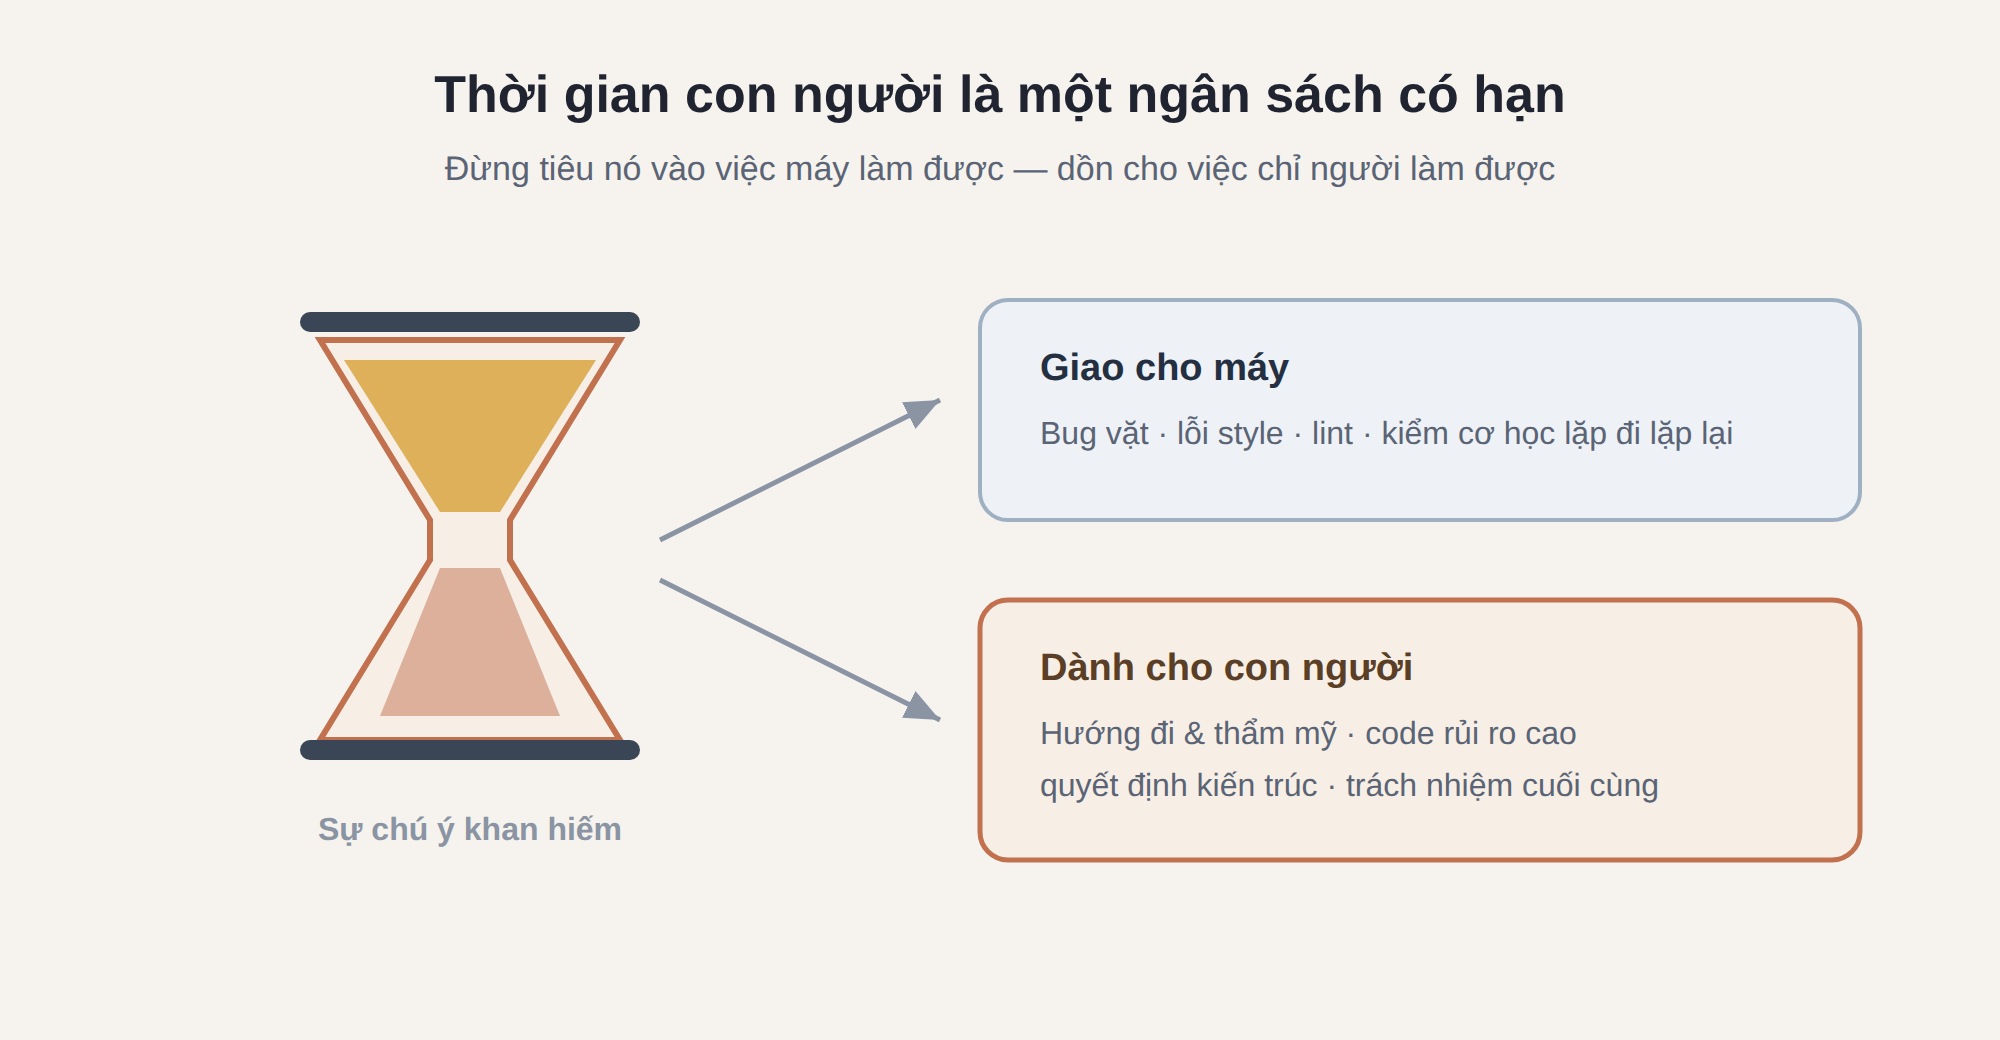
Họ coi sự chú ý của con người như một ví tiền có hạn, và cố tình không tiêu nó vào việc máy làm được. Cụ thể, việc được chia lại như sau:
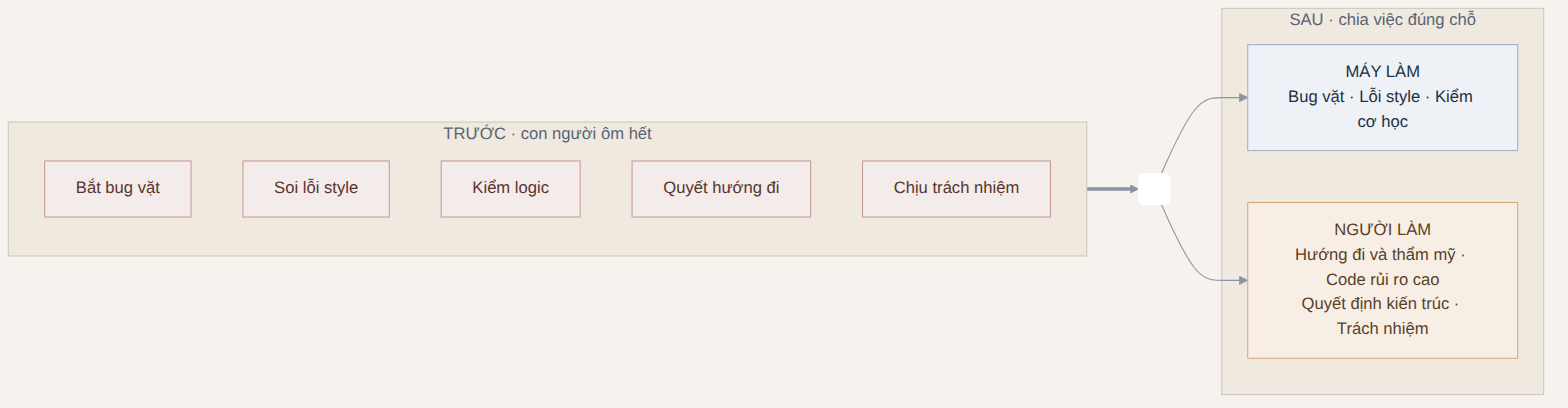
Đây chính là lúc câu “thời gian con người là tài nguyên khan hiếm” biến thành kiến trúc thật, không phải khẩu hiệu. Thậm chí họ đo cả thời gian con người như một chỉ số chính thức: số lần duyệt mỗi PR, số comment, thời gian chờ — và lấy tỉ lệ revert/sự cố làm lan can bảo vệ.
Góc nhìn của một team lead/reviewer: áp dụng được tới đâu?
Mình đọc câu chuyện này với vai trò người review code của người khác và chịu trách nhiệm về quy trình của team. Nên câu hỏi của mình không phải “công cụ này xịn không”, mà là: “Nó có mua lại được thời gian — thứ khan hiếm nhất của team mình — không? Đổi lại bằng rủi ro gì?”
Cái mình lấy ngay, gần như không bàn cãi
- Để AI/máy bắt lỗi cơ học. Phần lớn comment review của team mình hiện nay là thứ máy làm tốt hơn: thiếu test, lint, naming, null-check. Gõ mấy comment đó là tiêu thời gian vào việc máy làm được 24/7 mà không cáu.
- Bắt tác giả tự kiểm chứng trước khi mở PR. Gần như miễn phí, chỉ là thay đổi văn hóa: PR phải kèm bằng chứng đã chạy (test pass, ảnh chụp, lệnh reproduce). Cắt ngay vòng “bạn test chưa / để mình chạy thử”.
- Duyệt co giãn theo rủi ro. Ý mình tâm đắc nhất. Nhiều team đối xử mọi PR như nhau — sửa một dòng docs cũng cần duyệt y như sửa logic thanh toán. Đó là rải mỏng sự chú ý một cách lãng phí. Phân tầng tức là dồn mắt người vào chỗ hậu quả lớn.
Cái mình lấy nhưng phải sửa cho hợp quy mô
Thành thật: Anthropic có 30.000 thay đổi mỗi ngày, có đội xây eval riêng, có hạ tầng merge queue và feature flag trưởng thành. Team thường không có. Bê nguyên xi là sai.
- Multi-agent bỏ phiếu quá tốn token và thời gian ở quy mô nhỏ, nên bắt đầu bằng 1 AI reviewer cho mỗi PR, chỉ thêm bỏ phiếu khi nhiễu thực sự làm phiền.
- Classifier chấm rủi ro lý tưởng, nhưng bước đầu thay bằng luật đơn giản theo đường dẫn file: đụng
payment/,auth/,migration/thì rủi ro cao, bắt buộc người duyệt; đụngdocs/,test/,i18n/thì rủi ro thấp. Luật tay trước, học máy sau. - Security blocking giữ tinh thần “chặn cứng”, nhưng quy mô nhỏ chỉ cần SAST và quét secret trong CI, chưa cần agent bảo mật riêng.
Cái mình cảnh giác (và phản biện)
- “AI sai dưới 1%” dễ bị hiểu nhầm. Con số đó nói về báo nhầm (false positive) thấp, không nói gì về bỏ sót (false negative). Nỗi sợ của mình: team dần tin AI tới mức ngừng suy nghĩ, rồi một lỗi nghiệp vụ tinh vi trôi qua vì “AI với CI đều xanh”. Vì vậy phải giữ chặt luật của chính Anthropic: code rủi ro cao luôn phải có mắt người.
- “Code không ai đọc.” Chính Addy Osmani có một bài tên “The Code Nobody Reads”. Khi máy viết cộng máy review, dễ sinh ra code chạy được, pass hết cổng, nhưng không con người nào thật sự hiểu. Với thứ phải bảo trì nhiều năm thì đó là nợ kỹ thuật trá hình.
- Chi phí và độ trễ. Mỗi lớp AI đều tốn tiền và thêm thời gian chờ. Nếu AI review làm PR chờ thêm 10 phút chỉ để bắt một cái nit thì nó đang tiêu đúng cái tài nguyên ta định tiết kiệm. Phải đo, và sẵn sàng tắt lớp không đáng.
Chốt lại một câu
Phương pháp này áp dụng được. Nhưng giá trị thật không nằm ở “có AI review” — mà ở một cú dịch chuyển tư duy mà mọi team copy được không tốn token nào: coi sự chú ý của con người là ngân sách có hạn, và thiết kế quy trình để chỉ tiêu nó vào nơi hậu quả lớn nhất. AI chỉ giúp ngân sách đó đi xa hơn.
Team nào chưa phân tầng rủi ro, chưa bắt tác giả tự kiểm chứng, chưa tự động hóa bắt lỗi cơ học thì nên làm ba việc đó trước, rồi mới gắn agent. Và phép thử mình tự hỏi trước mỗi quy trình mới, rất đơn giản: “Việc này đang lấy một giờ của con người để làm thứ máy làm được, hay đang để con người làm đúng thứ chỉ con người làm được?”
Nguồn tham khảo
- Addy Osmani — “How the Claude Code team does code review”
- Bài gốc Anthropic / Claude Code
- Addy Osmani — “The Code Nobody Reads”
- Phân tích bên thứ ba (SmartScope)
- “Claude Reviewing Claude: Anthropic’s Code Review Process Has No Second Model”
Ghi chú: các số liệu do Anthropic tự công bố trong bối cảnh nội bộ, chưa kiểm chứng độc lập — nên hiểu theo hướng xu hướng.